
statistics --- 数学的統計関数
Added in version 3.4.
ソースコード: Lib/statistics.py
このモジュールは、数値 (Real 型) データを数学的に統計計算するための関数を提供します。
このモジュールは、 NumPy, SciPy のような third-party ライブラリや、Minitab、SAS、Matlab のようなプロ統計家向けのフル装備なプロプライエタリ統計パッケージと競合することを意図していません。グラフ関数電卓のレベルを対象としています。
特に明記しない限り、これらの関数は int, float, Decimal そして Fraction をサポートします。他の型 (算術型及びそれ以外) は現在サポートされていません。型が混ざったコレクションも未定義で実装依存です。入力データが複数の型からなる場合、map() を使用すると正しい結果が得られるでしょう。 例: map(float, input_data)。
あるデータセットでは欠損値を表すために NaN (not a number) を使います。 NaNは通常と異なる比較セマンティクスを持つため、ソートやカウントを行う統計関数では、驚きや未定義の振る舞いを引き起こします。 影響を受ける関数は median(), median_low(), median_high(), median_grouped(), mode(), multimode(), そして quantiles() です。 これらの関数を呼ぶ前に、 NaN 値を取り除く必要があります:
>>> from statistics import median
>>> from math import isnan
>>> from itertools import filterfalse

>>> data = [20.7, float('NaN'),19.2, 18.3, float('NaN'), 14.4]
>>> sorted(data)  # 予想外の動作になる
[20.7, nan, 14.4, 18.3, 19.2, nan]
>>> median(data)  # 予想外の結果になる
16.35

>>> sum(map(isnan, data))    # 欠損値の数
2
>>> clean = list(filterfalse(isnan, data))  # NaN を取り除く
>>> clean
[20.7, 19.2, 18.3, 14.4]
>>> sorted(clean)  # 今度は期待どおりにソートされる
[14.4, 18.3, 19.2, 20.7]
>>> median(clean)       # 今度は結果が適切に定まる
18.75
平均及び中心位置の測度
これらの関数は、母集団や標本の平均値または代表値を計算します。
データの算術平均 (いわゆる「平均」) 。 |
|
重み付けも指定できる、高速な浮動小数点数の算術平均。 |
|
データの幾何平均。 |
|
データの調和平均。 |
|
データの確率密度分布の推定。 |
|
kde() が生成した確率密度関数 (PDF) からのランダムサンプリング。 |
|
データのメジアン(中央値)。 |
|
データの low median。 |
|
データの high median。 |
|
階級にまとめられたデータの中央値 (50 パーセンタイル)。 |
|
離散/名義尺度データの最頻値 (single mode) 。 |
|
離散/名義尺度データの最頻値 (list of modes) 。 |
|
データの等確率での分割。 |
分散の測度
これらの関数は、母集団や標本の値が代表値や平均値からどの程度ばらつくかを表す測度を計算します。
データの母標準偏差。 |
|
データの母分散。 |
|
データの標本標準偏差。 |
|
データの標本分散。 |
2入力間の関係の統計
これらの関数は、2つの入力間の関係について統計量を計算します。
2変数の標本共分散。 |
|
ピアソンとスピアマンの相関係数。 |
|
単回帰の傾きと切片。 |
関数の詳細
註釈: 関数の引数となるデータをソートしておく必要はありません。例の多くがソートされているのは見やすさのためです。
- statistics.mean(data)
シーケンス型またはイテラブルになり得る data の標本算術平均を返します。
算術平均はデータの総和をデータ数で除したものです。単に「平均」と呼ばれることも多いですが、数学における平均の一種に過ぎません。データの中心位置の測度の一つです。
data が空の場合
StatisticsErrorを送出します。使用例:
>>> mean([1, 2, 3, 4, 4])
2.8
>>> mean([-1.0, 2.5, 3.25, 5.75])
2.625

>>> from fractions import Fraction as F
>>> mean([F(3, 7), F(1, 21), F(5, 3), F(1, 3)])
Fraction(13, 21)

>>> from decimal import Decimal as D
>>> mean([D("0.5"), D("0.75"), D("0.625"), D("0.375")])
Decimal('0.5625')
注釈
mean は 外れ値 (outliers) の影響を強く受け、必ずしもデータ点の典型例とはなりません。効率が悪いものの、より堅牢な、 中心的な傾向 (central tendency) の尺度については、
median()を参照してください。標本平均は真の母平均の不偏推定量です。 そのため、取り得るすべての標本にわたって
mean(sample)を平均すると、母集団全体の真の平均に収束します。 data が標本ではなく母集団全体を表す場合、mean(data)は真の母平均 μ の計算と同じです。
- statistics.fmean(data, weights=None)
data を float に変換し、算術平均を計算します。
mean()関数より高速に動作し、常にfloatを返します。 data はシーケンスまたはイテラブルにできます。 入力データが空の場合はStatisticsErrorを送出します。>>> fmean([3.5, 4.0, 5.25]) 4.25
必要に応じて重み付けを指定できます。 例えば、教授が小テスト 20%、宿題 20%、中間試験 30%、期末試験 30% の重みで授業の成績を付けるとします。
>>> grades = [85, 92, 83, 91]
>>> weights = [0.20, 0.20, 0.30, 0.30]
>>> fmean(grades, weights)
87.6
weights を指定する場合は data と同じ長さでなければならず、異なる場合は
ValueErrorを送出します。Added in version 3.8.
バージョン 3.11 で変更: weights のサポートが追加されました。
- statistics.geometric_mean(data)
data を浮動小数点数に変換して幾何平均を計算します。
幾何平均は、値の積を使って data の中心傾向や代表値を表します (算術平均が和を使うのとは対照的です)。
入力データが空の場合、ゼロを含む場合、または負の値を含む場合は
StatisticsErrorを送出します。 data はシーケンスまたはイテラブルにできます。厳密な結果を得るための特別な処理は行いません (将来変更される可能性はあります)。
>>> round(geometric_mean([54, 24, 36]), 1)
36.0
Added in version 3.8.
- statistics.harmonic_mean(data, weights=None)
実数のシーケンスまたはイテラブル data の調和平均を返します。 weights を省略するか
Noneにすると、すべての値の重みを同じと見なします。調和平均(harmonic mean)は、データの逆数の算術平均
mean()の逆数です。例えば、3つの値 a, b, c の調和平均は3/(1/a + 1/b + 1/c)になります。いずれかの値が0の場合、結果は0になります。調和平均は平均の一種で、データの中心位置の測度です。速度のような比(ratios)や率(rates)を平均するときにしばしば適切です。
車が最初の 10 km を時速 40 km、次の 10 km を時速 60 km で走るとします。 平均速度はいくらになるでしょうか。
>>> harmonic_mean([40, 60])
48.0
車が最初の 5 km を時速 40 km で走り、渋滞を抜けた後は時速 60 km に加速して残りの 30 km を走るとします。 平均速度はいくらになるでしょうか。
>>> harmonic_mean([40, 60], weights=[5, 30])
56.0
data が空の場合、負の要素がある場合、または重み付きの和が正でない場合は
StatisticsErrorを送出します。現在のアルゴリズムは、入力にゼロが現れると計算を打ち切ります。 そのため、それ以降の入力が有効かどうかは検査しません (この動作は将来変更される可能性があります)。
Added in version 3.6.
バージョン 3.10 で変更: weights のサポートが追加されました。
- statistics.kde(data, h, kernel='normal', *, cumulative=False)
カーネル密度推定 (KDE): 離散的な標本から連続的な確率密度関数または累積分布関数を作成します。
基本的な考え方は、カーネル関数 でデータを平滑化し、標本から母集団について推測できるようにすることです。
平滑化の度合いは、帯域幅と呼ばれる尺度パラメーター h で調整します。 値が小さいほど局所的な特徴が強調され、大きいほど滑らかな結果になります。
kernel は標本の各データ点に対する相対的な重みを決めます。 一般に、カーネルの形状の選択よりも、平滑化を調整する帯域幅の方が大きく影響します。
すべての標本点に重みを与えるカーネルには、normal (gauss)、logistic、sigmoid があります。
帯域幅内の標本点だけに重みを与えるカーネルには、rectangular (uniform)、triangular、parabolic (epanechnikov)、quartic (biweight)、triweight、cosine があります。
cumulative が真の場合は累積分布関数を返します。
data シーケンスが空の場合は
StatisticsErrorを送出します。Wikipedia の例 を使って、
kde()で小さな標本から推定した確率密度関数を生成し、描画できます。>>> sample = [-2.1, -1.3, -0.4, 1.9, 5.1, 6.2] >>> f_hat = kde(sample, h=1.5) >>> xarr = [i/100 for i in range(-750, 1100)] >>> yarr = [f_hat(x) for x in xarr]
xarrとyarrの点を使って確率密度関数 (PDF) のグラフを描けます。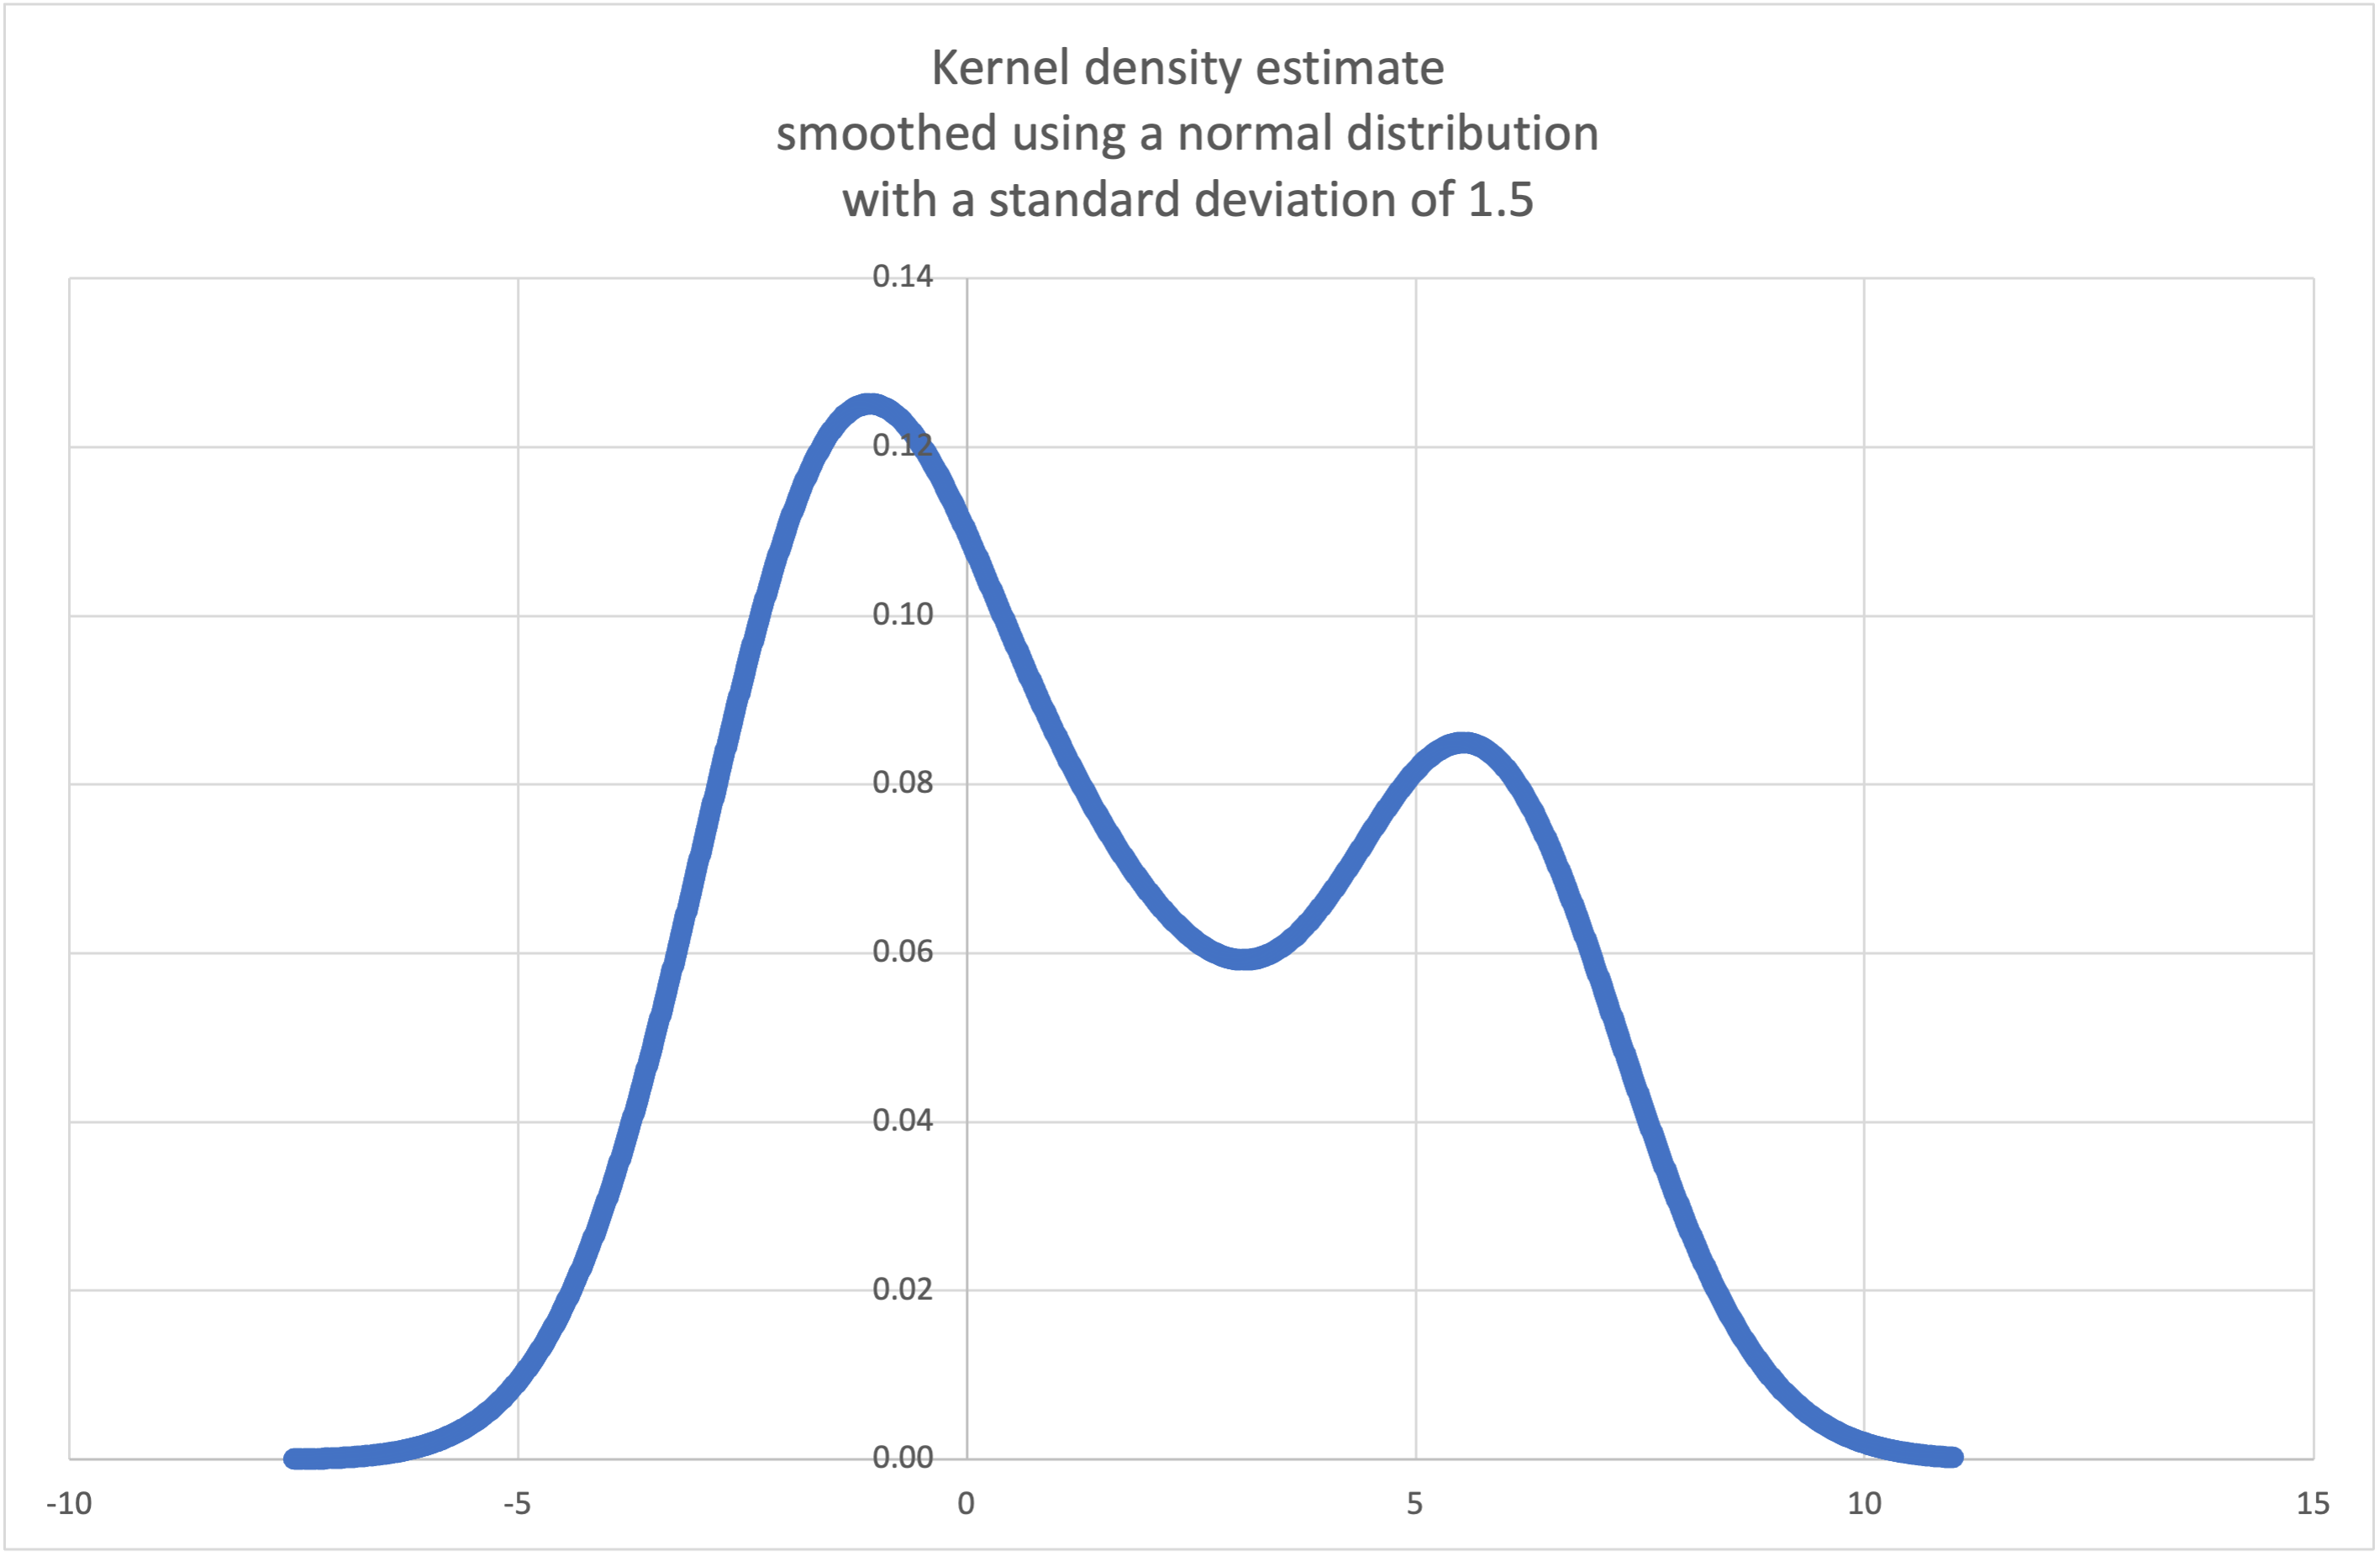
Because the returned
f_hatfunction is typically called many times, it caches the data for performance. To support dynamic datasets, this cache automatically refreshes whenever the length of the data changes. This allows new samples to be added as they become available.Added in version 3.13.
- statistics.kde_random(data, h, kernel='normal', *, seed=None)
kde(data, h, kernel)が生成する推定確率密度関数に従ってランダムな値を選ぶ関数を返します。seed を指定すると選択結果を再現できます。 将来、カーネルの逆累積分布関数の推定精度が向上すると、値がわずかに変わる可能性があります。 シードには整数、浮動小数点数、str、bytes を使えます。
data シーケンスが空の場合は
StatisticsErrorを送出します。kde()の例に続けて、kde_random()を使うと、推定した確率密度関数から新しい値をランダムに選べます。>>> data = [-2.1, -1.3, -0.4, 1.9, 5.1, 6.2] >>> rand = kde_random(data, h=1.5, seed=8675309) >>> new_selections = [rand() for i in range(10)] >>> [round(x, 1) for x in new_selections] [0.7, 6.2, 1.2, 6.9, 7.0, 1.8, 2.5, -0.5, -1.8, 5.6]
Added in version 3.13.
- statistics.median(data)
一般的な「中央2つの平均をとる」方法を使用して、数値データの中央値(中間値)を返します。もし data が空の場合、例外
StatisticsErrorが送出されます。data はシーケンス型またはイテラブルにもなれます。中央値は外れ値の影響を受けにくいため、中心位置のロバストな測度です。データ数が奇数の場合は中央の値を返します:
>>> median([1, 3, 5])
3
データ数が偶数の場合は、中央値は中央に最も近い2値の算術平均で補間されます:
>>> median([1, 3, 5, 7])
4.0
データが離散的で、中央値がデータ点にない値でも構わない場合に適しています。
データの順序は比較できても、数値ではなく加算できない場合は、代わりに
median_low()またはmedian_high()の使用を検討してください。
- statistics.median_low(data)
数値データの小さい方の中央値(low median)を返します。もし data が空の場合、
StatisticsErrorが送出されます。data はシーケンス型またはイテラブルにもなれます。low median は必ずデータに含まれています。データ数が奇数の場合は中央の値を返し、偶数の場合は中央の2値の小さい方を返します。
>>> median_low([1, 3, 5])
3
>>> median_low([1, 3, 5, 7])
3
データが離散的で、中央値が補間値よりもデータ点にある値の方が良い場合に用いてください。
- statistics.median_high(data)
データの大きい方の中央値(high median)を返します。もし data が空の場合、
StatisticsErrorが送出されます。 data はシーケンス型やイテラブルにもなれます。high median は必ずデータに含まれています。データ数が奇数の場合は中央の値を返し、偶数の場合は中央の2値の大きい方を返します。
>>> median_high([1, 3, 5])
3
>>> median_high([1, 3, 5, 7])
5
データが離散的で、中央値が補間値よりもデータ点にある値の方が良い場合に用いてください。
- statistics.median_grouped(data, interval=1.0)
連続する一定幅の区間の中点を中心に 階級やビンにまとめられた 数値データの中央値を推定します。
data は数値データの任意のイテラブルで、各値はビンの中点そのものでなければなりません。 少なくとも一つの値が必要です。
interval は各ビンの幅です。
例えば、人口統計の情報を連続する 10 歳ごとの年齢層にまとめ、各層を区間の下端から 5 歳上の中点で表すとします。
>>> from collections import Counter
>>> demographics = Counter({
...    25: 172,   # 20 歳から 30 歳
...    35: 484,   # 30 歳から 40 歳
...    45: 387,   # 40 歳から 50 歳
...    55:  22,   # 50 歳から 60 歳
...    65:   6,   # 60 歳から 70 歳
... })
...
50 パーセンタイル (中央値) は 1,071 人の集団のうち 536 番目の人です。 その人は 30 歳から 40 歳の年齢層に属します。
通常の
median()関数は、30 代の年齢層の全員がちょうど 35 歳だと仮定します。 その年齢層の 484 人が 30 歳から 40 歳の間に均等に分布していると仮定する方が妥当です。 そのためにはmedian_grouped()を使います。>>> data = list(demographics.elements()) >>> median(data) 35 >>> round(median_grouped(data, interval=10), 1) 37.5
データ点同士の間隔が interval の正確な整数倍になっていることは、呼び出し側で確認する必要があります。 正しい結果を得るにはこの条件が不可欠です。 関数はこの前提条件を検査しません。
入力には、補間の段階で浮動小数点数に変換できる任意の数値型を使えます。
- statistics.mode(data)
離散データまたは名義尺度データ data の中で、最も出現回数が多いデータ点を一つ返します。 最頻値 (存在する場合) は最も代表的な値であり、中心位置の測度となります。
同じ頻度の最頻値が複数ある場合は、data で最初に現れたものを返します。 それらのうち最小値または最大値が欲しい場合は、
min(multimode(data))またはmax(multimode(data))を使ってください。 入力 data が空の場合はStatisticsErrorを送出します。modeは離散データであることを想定していて、1つの値を返します。これは学校で教わるような最頻値の標準的な取扱いです:>>> mode([1, 1, 2, 3, 3, 3, 3, 4]) 3
The mode is unique in that it is the only statistic in this package that also applies to nominal (non-numeric) data:
>>> mode(["red", "blue", "blue", "red", "green", "red", "red"])
'red'
入力にはハッシュ可能な値だけを使えます。
set型を扱うにはfrozensetへの変換を検討してください。list型を扱うにはtupleへの変換を検討してください。 型が混在する入力や入れ子の入力では、低速ですが等値比較だけを使う、計算量が二次のアルゴリズムmax(data, key=data.count)を検討してください。バージョン 3.8 で変更: 最頻値が複数あるデータセットでも、最初に現れた最頻値を返すようになりました。 以前は最頻値が複数見つかると
StatisticsErrorを送出していました。
- statistics.multimode(data)
最も出現回数が多い値を、data に最初に現れた順序のリストで返します。 最頻値が複数あれば複数の結果を返し、data が空なら空のリストを返します。
>>> multimode('aabbbbccddddeeffffgg')
['b', 'd', 'f']
>>> multimode('')
[]
Added in version 3.8.
- statistics.pstdev(data, mu=None)
母標準偏差 (母分散の平方根) を返します。引数や詳細は
pvariance()を参照してください。>>> pstdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 0.986893273527251
- statistics.pvariance(data, mu=None)
data の母分散を返します。data は実数の空でないシーケンスまたはイテラブルです。分散、すなわち2次の中心化モーメントはデータの散らばり具合の測度です。分散が大きいデータはばらつきが大きく、分散が小さいデータは平均値のまわりに固まっています。
省略可能な二つ目の引数 mu を指定する場合、data の 母平均 を渡します。 平均以外の点のまわりの二次モーメントを計算するためにも使えます。 省略するか
None(デフォルト) にすると、算術平均を自動的に計算します。母集団全体から分散を計算する場合に用いてください。標本から分散を推定する場合は
variance()を使いましょう。data が空の場合
StatisticsErrorを送出します。例:
>>> data = [0.0, 0.25, 0.25, 1.25, 1.5, 1.75, 2.75, 3.25]
>>> pvariance(data)
1.25
既にデータの平均値を計算している場合、それを第2引数 mu に渡して再計算を避けることが出来ます:
>>> mu = mean(data)
>>> pvariance(data, mu)
1.25
Decimal と Fraction がサポートされています:
>>> from decimal import Decimal as D
>>> pvariance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('24.815')

>>> from fractions import Fraction as F
>>> pvariance([F(1, 4), F(5, 4), F(1, 2)])
Fraction(13, 72)
注釈
母集団全体で呼んだ場合は母分散 σ² を返します。代わりに標本で呼んだ場合は biased variance s²、すなわち自由度 N の分散を返します。
何らかの方法で真の母平均 μ が分かっている場合、その母平均を二つ目の引数に渡すと、この関数で標本の分散を計算できます。 データ点が母集団からの無作為標本であれば、結果は母分散の不偏推定量になります。
- statistics.stdev(data, xbar=None)
標本標準偏差 (標本分散の平方根) を返します。引数や詳細は
variance()を参照してください。>>> stdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 1.0810874155219827
- statistics.variance(data, xbar=None)
data の標本分散を返します。data は少なくとも2つの実数の iterable です。分散、すなわち2次の中心化モーメントはデータの散らばり具合の測度です。分散が大きいデータはばらつきが大きく、分散が小さいデータは平均値のまわりに固まっています。
省略可能な二つ目の引数 xbar を指定する場合、data の 標本平均 を渡します。 省略するか
None(デフォルト) にすると、平均を自動的に計算します。データが母集団の標本であるときに用いてください。母集団全体から分散を計算するには
pvariance()を参照してください。data に含まれる値が 2 個未満の場合は
StatisticsErrorを送出します。例:
>>> data = [2.75, 1.75, 1.25, 0.25, 0.5, 1.25, 3.5]
>>> variance(data)
1.3720238095238095
データの標本平均をすでに計算している場合は、省略可能な二つ目の引数 xbar に渡して再計算を避けられます。
>>> m = mean(data)
>>> variance(data, m)
1.3720238095238095
この関数は引数として渡した xbar が実際の平均値かどうかチェックしません。任意の値を xbar に渡すと無効な結果やありえない結果が返ることがあります。
Decimal と Fraction がサポートされています:
>>> from decimal import Decimal as D
>>> variance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('31.01875')

>>> from fractions import Fraction as F
>>> variance([F(1, 6), F(1, 2), F(5, 3)])
Fraction(67, 108)
注釈
Bessel 補正済みの標本分散 s²、すなわち自由度 N-1 の分散です。 データ点が母集団を代表している場合 (たとえば独立で同一の分布に従う場合)、戻り値は真の母分散の不偏推定量となります。
何らかの方法で真の母平均 μ を知っている場合、それを
pvariance()の引数 mu に渡して標本の分散を計算することが出来ます。
- statistics.quantiles(data, *, n=4, method='exclusive')
data を等確率の n 個の連続する区間に分割します。 区間を区切る
n - 1個の分割点のリストを返します。四分位数を求めるには n を 4 (デフォルト) に、十分位数には 10 に設定します。 パーセンタイルを求めるには n を 100 にすると、data を同じ大きさの 100 個のグループに分ける 99 個の分割点が得られます。 n が 1 以上でない場合は
StatisticsErrorを送出します。data は標本データを含む任意のイテラブルにできます。 意味のある結果を得るには、data のデータ点の数が n より多いことが望まれます。 データ点が一つもなければ
StatisticsErrorを送出します。分割点は最も近い二つのデータ点から線形補間します。 例えば、標本値
100と112の間を 3 分の 1 進んだ位置に分割点がある場合、その値は104になります。分位数の計算方法 method は、data が母集団の取り得る最小値と最大値を含むかどうかに応じて変えられます。
デフォルトの method は "exclusive" で、標本に含まれる値よりも極端な値を取り得る母集団から採取したデータに使います。 ソート済みの m 個のデータ点のうち i 番目 の点より小さい値を取る母集団の割合を、
i / (m + 1)で計算します。 標本値が九つの場合は、ソートして順に 10%、20%、30%、40%、50%、60%、70%、80%、90% のパーセンタイルを割り当てます。method を "inclusive" に設定する方法は、母集団全体のデータを記述する場合や、母集団の最も極端な値を含むと分かっている標本に使います。 data の最小値を 0 パーセンタイル、最大値を 100 パーセンタイルとして扱います。 ソート済みの m 個のデータ点のうち i 番目 の点より小さい値を取る母集団の割合を、
(i - 1) / (m - 1)で計算します。 標本値が 11 個の場合は、ソートして順に 0%、10%、20%、30%、40%、50%、60%、70%、80%、90%、100% のパーセンタイルを割り当てます。# 実測した標本データの十分位数による分割点 >>> data = [105, 129, 87, 86, 111, 111, 89, 81, 108, 92, 110, ... 100, 75, 105, 103, 109, 76, 119, 99, 91, 103, 129, ... 106, 101, 84, 111, 74, 87, 86, 103, 103, 106, 86, ... 111, 75, 87, 102, 121, 111, 88, 89, 101, 106, 95, ... 103, 107, 101, 81, 109, 104] >>> [round(q, 1) for q in quantiles(data, n=10)] [81.0, 86.2, 89.0, 99.4, 102.5, 103.6, 106.0, 109.8, 111.0]
Added in version 3.8.
バージョン 3.13 で変更: 入力のデータ点が一つだけの場合にも例外を送出しなくなりました。 これにより、標本点を一つずつ追加しながら分位数の推定値を求め、新しいデータ点の追加ごとに精度を高められます。
- statistics.covariance(x, y, /)
Return the sample covariance of two inputs x and y. Covariance is a measure of the joint variability of two inputs.
両方の入力は同じ長さ (2 以上) でなければならず、そうでなければ
StatisticsErrorを送出します。例:
>>> x = [1, 2, 3, 4, 5, 6, 7, 8, 9]
>>> y = [1, 2, 3, 1, 2, 3, 1, 2, 3]
>>> covariance(x, y)
0.75
>>> z = [9, 8, 7, 6, 5, 4, 3, 2, 1]
>>> covariance(x, z)
-7.5
>>> covariance(z, x)
-7.5
Added in version 3.10.
- statistics.correlation(x, y, /, *, method='linear')
Return the Pearson's correlation coefficient for two inputs. Pearson's correlation coefficient r takes values between -1 and +1. It measures the strength and direction of a linear relationship.
method が "ranked" の場合、二つの入力の スピアマンの順位相関係数 を計算します。 データを順位に置き換え、同じ値には順位の平均を割り当てることで同順位にします。 得られる係数は単調な関係の強さを表します。
スピアマンの相関係数は、順序尺度データや、ピアソンの相関係数に必要な線形の関係を満たさない連続データに適しています。
Both inputs must be of the same length (no less than two), and need not to be constant, otherwise
StatisticsErroris raised.ケプラーの惑星運動の法則 を使った例です。
>>> # 水星、金星、地球、火星、木星、土星、天王星、海王星
>>> orbital_period = [88, 225, 365, 687, 4331, 10_756, 30_687, 60_190]    # 日
>>> dist_from_sun = [58, 108, 150, 228, 778, 1_400, 2_900, 4_500] # 百万 km

>>> # 完全な単調関係があることを示す
>>> correlation(orbital_period, dist_from_sun, method='ranked')
1.0

>>> # 線形関係は完全ではないことを確認する
>>> round(correlation(orbital_period, dist_from_sun), 4)
0.9882

>>> # ケプラーの第三法則を示す: 公転周期の二乗と
>>> # 太陽からの距離の三乗の間には線形の相関がある。
>>> period_squared = [p * p for p in orbital_period]
>>> dist_cubed = [d * d * d for d in dist_from_sun]
>>> round(correlation(period_squared, dist_cubed), 4)
1.0
Added in version 3.10.
バージョン 3.12 で変更: スピアマンの順位相関係数に対応しました。
- statistics.linear_regression(x, y, /, *, proportional=False)
通常の最小二乗法で推定した 単回帰 のパラメーターである傾きと切片を返します。 単回帰は独立変数 x と従属変数 y の関係を次の一次関数で記述します。
y = slope * x + intercept + noise
slopeとinterceptは推定する回帰パラメーターで、noiseは線形回帰で説明できなかったデータの変動を表します (従属変数の予測値と実測値の差に相当します)。Both inputs must be of the same length (no less than two), and the independent variable x cannot be constant; otherwise a
StatisticsErroris raised.例えば モンティ・パイソンの映画の公開日 を使うと、同じ制作ペースを維持していた場合に 2019 年までに何本の映画が制作されていたかを予測できます。
>>> year = [1971, 1975, 1979, 1982, 1983]
>>> films_total = [1, 2, 3, 4, 5]
>>> slope, intercept = linear_regression(year, films_total)
>>> round(slope * 2019 + intercept)
16
proportional が真の場合、独立変数 x と従属変数 y は正比例すると仮定します。 データを原点を通る直線に当てはめます。 intercept は常に 0.0 になるため、基になる一次関数は次のように簡単になります。
y = slope * x + noise
correlation()の例に続けて、惑星に基づくモデルで準惑星の軌道距離をどの程度予測できるかを調べます。>>> model = linear_regression(period_squared, dist_cubed, proportional=True) >>> slope = model.slope >>> # 準惑星: 冥王星、エリス、マケマケ、ハウメア、ケレス >>> orbital_periods = [90_560, 204_199, 111_845, 103_410, 1_680] # 日 >>> predicted_dist = [math.cbrt(slope * (p * p)) for p in orbital_periods] >>> list(map(round, predicted_dist)) [5912, 10166, 6806, 6459, 414] >>> [5_906, 10_152, 6_796, 6_450, 414] # 実際の距離 (百万 km 単位) [5906, 10152, 6796, 6450, 414]
Added in version 3.10.
バージョン 3.11 で変更: proportional に対応しました。
例外
例外が1つ定義されています:
- exception statistics.StatisticsError
統計関係の例外。
ValueErrorの派生クラス。
NormalDist オブジェクト
NormalDist は 確率変数 の正規分布を作成・操作するためのツールです。
測定データの平均と標準偏差を一つにまとめて扱うクラスです。
正規分布は 中心極限定理 によって現れ、統計学で幅広く応用されています。
- class statistics.NormalDist(mu=0.0, sigma=1.0)
新しい NormalDist オブジェクトを返します。 mu は 算術平均、sigma は 標準偏差 を表します。
sigma が負の数の場合
StatisticsErrorを送出します。- classmethod from_samples(data)
fmean()とstdev()を使って data から mu と sigma を推定し、正規分布のインスタンスを作成します。data は任意の iterable にできますが、各値は
float型に変換できなければなりません。 中心の値の推定には少なくとも一点、散らばりの推定には少なくとも二点が必要なため、data に要素が二つ以上なければStatisticsErrorを送出します。
- samples(n, *, seed=None)
指定された平均と標準偏差を持つ分布から、n 個の無作為標本を生成します。
float値のlistを返します。seed を指定すると、内部で使う乱数生成器の新しいインスタンスを作成します。 マルチスレッド環境でも再現可能な結果を得るのに便利です。
バージョン 3.13 で変更.
より高速なアルゴリズムに切り替わりました。 以前のバージョンの標本を再現するには
random.seed()とrandom.gauss()を使ってください。
- pdf(x)
確率密度関数 (PDF) を使い、確率変数 X が指定された値 x の近くにある相対的な起こりやすさを計算します。 数学的には、dx をゼロに近づけたときの比
P(x <= X < x+dx) / dxの極限です。相対的な起こりやすさは、標本が狭い範囲内に現れる確率をその範囲の幅で割って計算します (そのため「密度」と呼びます)。 他の点と比較した相対的な値なので、
1.0を超えることもあります。
- cdf(x)
累積分布関数 (CDF) を使い、確率変数 X が x 以下になる確率を計算します。 数学的には
P(X <= x)と書きます。
- inv_cdf(p)
逆累積分布関数を計算します。 分位点関数 や パーセント点 関数とも呼ばれます。 数学的には
x : P(X <= x) = pと書きます。確率変数 X がある値以下になる確率が、指定された確率 p に等しくなるような値 x を求めます。
- overlap(other)
二つの正規確率分布の一致の度合いを測ります。 二つの確率密度関数の重なり部分の面積 を表す、0.0 から 1.0 の値を返します。
- quantiles(n=4)
正規分布を等確率の n 個の連続する区間に分割します。 区間を区切る (n - 1) 個の分割点のリストを返します。
四分位数を求めるには n を 4 (デフォルト) に、十分位数には 10 に設定します。 パーセンタイルを求めるには n を 100 にすると、正規分布を同じ大きさの 100 個のグループに分ける 99 個の分割点が得られます。
- zscore(x)
x が正規分布の平均より標準偏差の何倍だけ上または下にあるかを表す 標準得点 を、
(x - mean) / stdevで計算します。Added in version 3.9.
NormalDistのインスタンスは、定数との加算、減算、乗算、除算に対応しています。 これらの操作は平行移動と拡大縮小に使います。 例えば次のように使えます。>>> temperature_february = NormalDist(5, 2.5) # 摂氏 >>> temperature_february * (9/5) + 32 # 華氏 NormalDist(mu=41.0, sigma=4.5)
定数を
NormalDistのインスタンスで割ることはできません。 結果が正規分布にならないためです。独立した変数の加法的な効果から正規分布が生じるため、
NormalDistのインスタンスとして表された 独立な二つの正規確率変数を加算・減算できます。 例えば次のように使えます。>>> birth_weights = NormalDist.from_samples([2.5, 3.1, 2.1, 2.4, 2.7, 3.5]) >>> drug_effects = NormalDist(0.4, 0.15) >>> combined = birth_weights + drug_effects >>> round(combined.mean, 1) 3.1 >>> round(combined.stdev, 1) 0.5
Added in version 3.8.
例とレシピ
典型的な確率の問題
NormalDist を使うと、典型的な確率の問題を簡単に解けます。
例えば SAT 試験の過去のデータ によれば、得点は平均 1060、標準偏差 195 の正規分布に従います。 得点を最も近い整数に丸めたときに、1100 点から 1200 点の間に入る生徒の割合を求めます。
>>> sat = NormalDist(1060, 195)
>>> fraction = sat.cdf(1200 + 0.5) - sat.cdf(1100 - 0.5)
>>> round(fraction * 100.0, 1)
18.4
>>> list(map(round, sat.quantiles()))
[928, 1060, 1192]
>>> list(map(round, sat.quantiles(n=10)))
[810, 896, 958, 1011, 1060, 1109, 1162, 1224, 1310]
シミュレーション用のモンテカルロ入力
解析的に解くのが難しいモデルの分布を推定するために、NormalDist で モンテカルロシミュレーション の入力標本を生成できます。
>>> def model(x, y, z):
...     return (3*x + 7*x*y - 5*y) / (11 * z)
...
>>> n = 100_000
>>> X = NormalDist(10, 2.5).samples(n, seed=3652260728)
>>> Y = NormalDist(15, 1.75).samples(n, seed=4582495471)
>>> Z = NormalDist(50, 1.25).samples(n, seed=6582483453)
>>> quantiles(map(model, X, Y, Z))
[1.4591308524824727, 1.8035946855390597, 2.175091447274739]
二項分布の近似
標本サイズが大きく、試行の成功確率が 50% に近い場合は、正規分布で 二項分布 を近似できます。
例えば、あるオープンソースカンファレンスには参加者が 750 人いて、定員 500 人の部屋が二つあるとします。 一方の部屋では Python の講演、他方では Ruby の講演を行います。 過去のカンファレンスでは参加者の 65% が Python の講演を選びました。 参加者の好みが変わっていないとすると、Python の部屋が定員を超えない確率はいくらでしょうか。
>>> n = 750             # 標本サイズ
>>> p = 0.65            # Python を選ぶ割合
>>> q = 1.0 - p         # Ruby を選ぶ割合
>>> k = 500             # 部屋の定員

>>> # 正規分布の累積分布関数による近似
>>> from math import sqrt
>>> round(NormalDist(mu=n*p, sigma=sqrt(n*p*q)).cdf(k + 0.5), 4)
0.8402

>>> # 二項分布の累積分布関数による厳密解
>>> from math import comb, fsum
>>> round(fsum(comb(n, r) * p**r * q**(n-r) for r in range(k+1)), 4)
0.8402

>>> # シミュレーションによる近似
>>> from random import seed, binomialvariate
>>> seed(8675309)
>>> mean(binomialvariate(n, p) <= k for i in range(10_000))
0.8406
ナイーブベイズ分類器
機械学習の問題には正規分布がよく現れます。
Wikipedia に ナイーブベイズ分類器の分かりやすい例 があります。 身長、体重、足のサイズなど、正規分布に従う特徴の測定値からその人の性別を予測する問題です。
8 人分の測定値を持つ訓練データセットが与えられています。
測定値は正規分布に従うと仮定して、NormalDist でデータをまとめます。
>>> height_male = NormalDist.from_samples([6, 5.92, 5.58, 5.92])
>>> height_female = NormalDist.from_samples([5, 5.5, 5.42, 5.75])
>>> weight_male = NormalDist.from_samples([180, 190, 170, 165])
>>> weight_female = NormalDist.from_samples([100, 150, 130, 150])
>>> foot_size_male = NormalDist.from_samples([12, 11, 12, 10])
>>> foot_size_female = NormalDist.from_samples([6, 8, 7, 9])
次に、特徴の測定値は分かっているものの、性別が不明な新しい人を考えます。
>>> ht = 6.0        # 身長
>>> wt = 130        # 体重
>>> fs = 8          # 足のサイズ
Starting with a 50% prior probability of being male or female, we compute the posterior as the prior times the product of likelihoods for the feature measurements given the gender:
>>> prior_male = 0.5
>>> prior_female = 0.5
>>> posterior_male = (prior_male * height_male.pdf(ht) *
...                   weight_male.pdf(wt) * foot_size_male.pdf(fs))

>>> posterior_female = (prior_female * height_female.pdf(ht) *
...                     weight_female.pdf(wt) * foot_size_female.pdf(fs))
最終的には事後確率が最大になる方を予測結果とします。 これは 最大事後確率、または MAP と呼ばれます。
>>> 'male' if posterior_male > posterior_female else 'female'
'female'