
heapq --- ヒープキューアルゴリズム
ソースコード: Lib/heapq.py
このモジュールではヒープキューアルゴリズムの一実装を提供しています。優先度キューアルゴリズムとしても知られています。
最小ヒープは、各親ノードの値がそのどの子ノードの値以下でもある二分木です。 この条件をヒープ不変式と呼びます。
この実装では最小ヒープをリストで表し、比較する要素が存在するすべての k について heap[k] <= heap[2*k+1] および heap[k] <= heap[2*k+2] が成り立ちます。
要素は 0 から数えます。
最小ヒープの興味深い性質は、最小の要素が常に根の heap[0] にあることです。
Max-heaps satisfy the reverse invariant: every parent node has a value
greater than any of its children. These are implemented as lists for which
maxheap[2*k+1] <= maxheap[k] and maxheap[2*k+2] <= maxheap[k] for all
k for which the compared elements exist.
The root, maxheap[0], contains the largest element;
heap.sort(reverse=True) maintains the max-heap invariant.
heapq の API は、教科書に載っているヒープアルゴリズムと 2 つの点で異なります。
(a) インデックスを 0 から数えます。
これにより、あるノードのインデックスとその子のインデックスの関係がやや分かりにくくなりますが、Python のインデックスは 0 から始まるため、この方が適しています。
(b) 教科書では、その場でのソートに適した最大ヒープを中心に扱うことがよくあります。
この実装では Python の リスト によりよく対応する最小ヒープを中心に扱います。
この 2 つの特徴により、ヒープを通常の Python リストとして自然に扱えます。
heap[0] が最小の要素で、heap.sort() を実行してもヒープ不変式が保たれます!
list.sort() と同様、この実装では最小ヒープと最大ヒープのどちらでも、比較に < 演算子だけを使います。
以下の API とこのドキュメントでは、単に ヒープ と呼ぶ場合は一般に最小ヒープを指します。
最大ヒープの API の名前には _max 接尾辞が付いています。
ヒープを作るには、[] で初期化したリストを使うか、既存のリストを heapify() または heapify_max() 関数でそれぞれ最小ヒープまたは最大ヒープに変換します。
最小ヒープには次の関数が用意されています。
- heapq.heapify(x)
リスト x をその場で最小ヒープに変換します。 処理時間は要素数に比例します。
- heapq.heappush(heap, item)
最小ヒープの不変式を保ちながら、値 item を heap に追加します。
- heapq.heappop(heap)
最小ヒープの不変式を保ちながら、heap の最小の要素を取り出して返します。 ヒープが空の場合は
IndexErrorを送出します。 最小の要素を削除せずに参照するにはheap[0]を使ってください。
- heapq.heappushpop(heap, item)
item を heap に追加し、その後で最小の要素を取り出して返します。 この操作は、
heappush()に続けてheappop()を個別に呼び出すより効率的です。
- heapq.heapreplace(heap, item)
heap から最小の要素を pop して返し、新たに item を push します。ヒープのサイズは変更されません。ヒープが空の場合、
IndexErrorが送出されます。この 1 回の操作は、
heappop()に続けてheappush()を呼び出すより効率的で、固定サイズのヒープを使う場合により適していることがあります。 pop/push の組み合わせは常にヒープから要素を返し、その要素を item で置き換えます。返される値は加えられた item よりも大きくなるかもしれません。それを望まないなら、代わりに
heappushpop()を使うことを考えてください。この push/pop の組み合わせは二つの値の小さい方を返し、大きい方の値をヒープに残します。
最大ヒープには次の関数が用意されています。
- heapq.heapify_max(x)
リスト x をその場で最大ヒープに変換します。 処理時間は要素数に比例します。
Added in version 3.14.
- heapq.heappush_max(heap, item)
最大ヒープの不変式を保ちながら、値 item を最大ヒープ heap に追加します。
Added in version 3.14.
- heapq.heappop_max(heap)
最大ヒープの不変式を保ちながら、最大ヒープ heap の最大の要素を取り出して返します。 最大ヒープが空の場合は
IndexErrorを送出します。 最大の要素を削除せずに参照するにはmaxheap[0]を使ってください。Added in version 3.14.
- heapq.heappushpop_max(heap, item)
item を最大ヒープ heap に追加し、その後で heap の最大の要素を取り出して返します。 この操作は、
heappush_max()に続けてheappop_max()を個別に呼び出すより効率的です。Added in version 3.14.
- heapq.heapreplace_max(heap, item)
最大ヒープ heap の最大の要素を取り出して返すとともに、新たに item を追加します。 最大ヒープのサイズは変わりません。 最大ヒープが空の場合は
IndexErrorを送出します。返される値は、追加した item より小さい場合があります。 詳しい使い方の注意点については、対応する関数
heapreplace()を参照してください。Added in version 3.14.
このモジュールではさらに3つのヒープに基く汎用関数を提供します。
- heapq.merge(*iterables, key=None, reverse=False)
複数のソートされた入力をマージ(merge)して一つのソートされた出力にします (たとえば、複数のログファイルの時刻の入ったエントリーをマージします)。ソートされた値にわたる iterator を返します。
sorted(itertools.chain(*iterables))と似ていますが、イテレータを返し、一度にはデータをメモリに読み込まず、それぞれの入力ストリームが予め(最小から最大へ)ソートされていることを仮定します。2 つのオプション引数があり、これらはキーワード引数として指定されなければなりません。
key は 1 つの引数からなる key function を指定します。この関数は、入力の各要素から比較のキーを取り出すのに使われます。デフォルト値は
Noneです (要素を直接比較します)。reverse は真偽値です。
Trueの場合は比較の向きを逆にして入力要素をマージします。sorted(itertools.chain(*iterables), reverse=True)と同様の動作にするには、すべての入力イテラブルをあらかじめ降順にソートしておく必要があります。バージョン 3.5 で変更: オプションの key 引数および reverse 引数を追加.
- heapq.nlargest(n, iterable, key=None)
iterable で定義されるデータセットのうち、最大値から降順に n 個の値のリストを返します。(あたえられた場合) key は、引数を一つとる、iterable のそれぞれの要素から比較キーを生成する関数を指定します(例
key=str.lower)。以下のコードと同等です:sorted(iterable, key=key, reverse=True)[:n]
- heapq.nsmallest(n, iterable, key=None)
iterable で定義されるデータセットのうち、最小値から昇順に n 個の値のリストを返します。(あたえられた場合) key は、引数を一つとる、iterable のそれぞれの要素から比較キーを生成する関数を指定します(例
key=str.lower)。以下のコードと同等です:sorted(iterable, key=key)[:n]
後ろ二つの関数は n の値が小さな場合に最適な動作をします。大きな値の時には sorted() 関数の方が効率的です。さらに、 n==1 の時には min() および max() 関数の方が効率的です。この関数を繰り返し使うことが必要なら、iterable を実際のヒープに変えることを考えてください。
基本的な例
すべての値をヒープに push してから最小値を 1 つずつ pop することで、ヒープソート を実装できます:
>>> def heapsort(iterable):
...     h = []
...     for value in iterable:
...         heappush(h, value)
...     return [heappop(h) for i in range(len(h))]
...
>>> heapsort([1, 3, 5, 7, 9, 2, 4, 6, 8, 0])
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
これは sorted(iterable) に似ていますが、 sorted() とは異なり、この実装はステーブルソートではありません。
ヒープの要素はタプルに出来ます。これは、追跡される主レコードとは別に (タスクの優先度のような) 比較値を指定するときに便利です:
>>> h = []
>>> heappush(h, (5, 'write code'))
>>> heappush(h, (7, 'release product'))
>>> heappush(h, (1, 'write spec'))
>>> heappush(h, (3, 'create tests'))
>>> heappop(h)
(1, 'write spec')
その他の用途
中央値 は、数値の集まりの中心傾向を表す指標です。 外れ値によって歪んだ分布では、中央値は平均値 (算術平均) より安定した推定値になります。 逐次中央値は、新しいデータが届くたびに中央値を更新する オンラインアルゴリズム です。
逐次中央値は、中央値以下の値を保持する最大ヒープと、中央値より大きな値を保持する最小ヒープという 2 つのヒープのサイズを釣り合わせることで効率的に実装できます。 2 つのヒープのサイズが同じなら、新しい中央値は両ヒープの先頭の値の平均になります。 そうでなければ、大きい方のヒープの先頭の値が中央値になります。
def running_median(iterable):
    "それまでに得られた値全体の中央値を yield します。"

    lo = []  # 最大ヒープ
    hi = []  # 最小ヒープ (lo と同じサイズか、1 つ小さいサイズ)

    for x in iterable:
        if len(lo) == len(hi):
            heappush_max(lo, heappushpop(hi, x))
            yield lo[0]
        else:
            heappush(hi, heappushpop_max(lo, x))
            yield (lo[0] + hi[0]) / 2
例えば:
>>> list(running_median([5.0, 9.0, 4.0, 12.0, 8.0, 9.0]))
[5.0, 7.0, 5.0, 7.0, 8.0, 8.5]
優先度キュー実装の注釈
優先度つきキュー は、ヒープの一般的な使い方で、実装にはいくつか困難な点があります:
ソート安定性: 優先度が等しい二つのタスクが、もともと追加された順序で返されるためにはどうしたらいいでしょうか?
(priority, task) ペアに対するタプルの比較は、priority が同じで task がデフォルトの比較順を持たないときに破綻します。
あるタスクの優先度が変化したら、どうやってそれをヒープの新しい位置に移動させるのでしょうか?
処理待ちのタスクを削除する必要がある場合、キュー内でどのように見つけて削除すればよいでしょうか?
最初の二つの困難の解決策は、項目を優先度、項目番号、そしてタスクを含む 3 要素のリストとして保存することです。この項目番号は、同じ優先度の二つのタスクが、追加された順序で返されるようにするための同点決勝戦として働きます。そして二つの項目番号が等しくなることはありませんので、タプルの比較が二つのタスクを直接比べようとすることはありえません。
比較できないタスク問題のもう一つの解決法は、タスクアイテムを無視して優先順序フィールドだけで比較するラッパークラスです:
from dataclasses import dataclass, field
from typing import Any

@dataclass(order=True)
class PrioritizedItem:
    priority: int
    item: Any=field(compare=False)
残る課題は、処理待ちのタスクを見つけて優先度を変更したり、完全に削除したりすることです。 キュー内の項目を参照する辞書を使えば、タスクを見つけられます。
項目を削除したり、優先度を変更することは、ヒープ構造の不変関係を壊すことになるので、もっと難しいです。ですから、可能な解決策は、その項目が無効であるものとしてマークし、必要なら変更された優先度の項目を加えることです:
pq = []                         # 項目をヒープ順に並べたリスト
entry_finder = {}               # タスクから項目へのマッピング
REMOVED = '<removed-task>'      # 削除したタスクのプレースホルダー
counter = itertools.count()     # 重複しない連番

def add_task(task, priority=0):
    '新しいタスクを追加するか、既存のタスクの優先度を更新します'
    if task in entry_finder:
        remove_task(task)
    count = next(counter)
    entry = [priority, count, task]
    entry_finder[task] = entry
    heappush(pq, entry)

def remove_task(task):
    """既存のタスクを REMOVED とマークします。
    見つからない場合は KeyError を送出します。
    """
    entry = entry_finder.pop(task)
    entry[-1] = REMOVED

def pop_task():
    """優先度の値が最小のタスクを削除して返します。
    空の場合は KeyError を送出します。
    """
    while pq:
        priority, count, task = heappop(pq)
        if task is not REMOVED:
            del entry_finder[task]
            return task
    raise KeyError('pop from an empty priority queue')
理論
ヒープとは、全ての k について、要素を 0 から数えたときに、a[k] <= a[2*k+1] かつ a[k] <= a[2*k+2] となる配列です。比較のために、存在しない要素を無限大と考えます。ヒープの興味深い属性は a[0] が常に最小の要素になることです。
上の一風変わった不変式は、勝ち抜き戦をメモリ上で効率的に表すためのものです。
下の数値は a[k] ではなく k です。
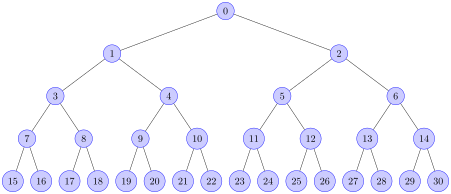
上の木構造では、各セル k の直下に 2*k+1 と 2*k+2 があります。
スポーツで見る通常の勝ち抜き戦では、各セルはその直下の 2 つのセルに対する勝者を表します。
勝者を木の下方へたどると、それまでに対戦した相手をすべて確認できます。
しかし、コンピューターでこのような勝ち抜き戦を利用する場合、勝者の履歴をたどる必要がないことも多くあります。
メモリを節約するため、勝者を上位へ進めたら、空いた場所を下位の別の要素で置き換えます。
この場合の規則は、あるセルとその直下の 2 つのセルが異なる 3 つの要素を持ち、上のセルが下の 2 つのセルに「勝つ」というものになります。
このヒープ不変式が常に守られれば、インデックス 0 は明らかに最勝者となります。最勝者の要素を除去し、"次の" 勝者を見つけるための最も単純なアルゴリズム的手法は、ある敗者要素 (ここでは上図のセル 30 とします) を 0 の場所に持っていき、この新しい 0 を濾過するようにしてツリーを下らせて値を交換してゆきます。不変関係が再構築されるまでこれを続けます。この操作は明らかに、ツリー内の全ての要素数に対して対数的な計算量となります。全ての要素について繰り返すと、 O(n log n) のソートになります。
このソートの良い点は、新たに挿入する要素が、最後に取り出された 0 番目の要素よりも "良い値" でない限り、ソートを行っている最中に新たな要素を効率的に追加できるというところです。この性質は、シミュレーション的な状況で、ツリーで全ての入力イベントを保持し、"勝者" の状況を最小のスケジュール時刻にするような場合に特に便利です。あるイベントが他のイベント群の実行をスケジュールする際、それらは未来にスケジュールされることになるので、それらのイベント群を容易にヒープに積むことができます。すなわち、ヒープはスケジューラを実装する上で良いデータ構造であるといえます (私はこれを MIDI シーケンサで使っています :-)。
これまで、スケジューラを実装するための様々なデータ構造が広範に研究されてきました。ヒープは、十分高速で、速度はおおむね一定であり、最悪の場合でも平均的な速度とさほど変わらないため、良いデータ構造といえます。しかし、最悪の場合にひどい速度になるとしても、全体的にはより効率の高い他のデータ構造表現も存在します。
ヒープはディスク上の大量のデータのソートにも非常に役立ちます。 ご存じのように、大規模なソートではまず「ラン」(ソート済みのシーケンスで、その大きさは通常、主記憶の容量に関係します) を生成し、続いてこれらのランをマージします。 このマージ処理は非常に巧妙に組み立てられることがよくあります [1]。 最初のソートで、できるだけ長いランを生成することが重要です。 勝ち抜き戦はそのための良い方法です。 利用可能なメモリをすべて使って勝ち抜き戦を保持し、現在のランに収まる要素を置き換えて木の下方へ移動させると、ランダムな入力に対してはメモリ容量の 2 倍の長さのランを生成できます。 おおむね順序の揃った入力なら、さらに長いランを生成できます。
さらに、0 番目の要素をディスクに出力して、現在の勝ち抜き戦に (最後に出力した値に "勝って" しまうために) 収められない入力を得たなら、ヒープには収まらないため、ヒープのサイズは減少します。 解放されたメモリは二つ目のヒープを段階的に構築するために巧妙に再利用することができ、この二つ目のヒープは最初のヒープが崩壊していくのと同じ速度で成長します。 最初のヒープが完全に消滅したら、ヒープを切り替えて新たなランを開始します。 なんと巧妙で効率的なのでしょう!
一言で言うと、ヒープは知って得するメモリ構造です。私はいくつかのアプリケーションでヒープを使っていて、'ヒープ' モジュールを常備するのはいい事だと考えています。:-)
脚注