
profiling.sampling --- 統計的プロファイラ
Added in version 3.15.
ソースコード: Lib/profiling/sampling/
Tachyon という名前の profiling.sampling モジュールは、スタックを定期的にサンプリングして Python プログラムを統計的にプロファイリングします。
Tachyon はスクリプトを直接実行することも、コードの変更や再起動なしに実行中の Python プロセスに接続することもできます。
サンプリングは対象プロセスの外部で行うため、オーバーヘッドはほぼゼロです。
そのため、開発環境と本番環境の両方に適しています。
統計的プロファイリングとは
統計的プロファイリングは、コールスタックのスナップショットを定期的に取得して、プログラムの動作を捉えます。 Tachyon は決定論的プロファイラのようにすべての関数呼び出しと復帰を計測するのではなく、一定の間隔でコールスタックを読み取り、その時点で実行中のコードを記録します。
この方法は、多くの CPU 時間を使う関数ほど、収集したサンプルに頻繁に現れるという単純な原理に基づいています。 Tachyon はプロファイリング中に数千のサンプルを集め、どこで時間を費やしているかを統計的に正確に推定します。 サンプルが多いほど、推定の精度は高くなります。
次の対話的な可視化では、サンプリングによるプロファイリングの仕組みを示します。 Play を押して Python プログラムの実行を開始し、プロファイラがコールスタックのスナップショットを定期的に取得する様子を確認してください。 sample interval を調整すると、サンプリングの頻度が結果にどう影響するかを確認できます。
時間の推定方法
Tachyon の出力に表示される時間は、直接測定した値ではなく、サンプル数から求めた推定値 です。 Tachyon は収集したサンプルに各関数が現れる回数を数え、サンプリング間隔を掛けて時間を推定します。
例えば、サンプリングレート 10 kHz で 10 秒間プロファイルすると、Tachyon は約 100,000 個のサンプルを収集します。 ある関数が 5,000 個のサンプル (全体の 5%) に現れた場合、Tachyon はその関数が 10 秒の 5%、つまり約 500 ミリ秒を使ったと推定します。 これは統計的な推定であり、正確な測定値ではありません。
推定の精度はサンプル数に依存します。 100,000 個のサンプルで 5% と表示される関数の誤差範囲は、およそ ±0.5% です。 サンプルが 1,000 個しかない場合、同じ 5% という値でも、実際の時間の割合は 3% から 7% のどこかかもしれません。
プロファイリングの時間を長くし、サンプリング間隔を短くすると結果の信頼性が増すのは、より多くのサンプルを集められるためです。 ほとんどの性能分析では、デフォルトの設定でボトルネックを特定し、最適化の方針を決めるのに十分な精度が得られます。
サンプリングは統計的な手法なので、結果は実行ごとに多少変わります。 ある実行で 12% と表示された関数が、次には 11% や 13% になるかもしれません。 これは正常で、想定される動作です。 厳密な割合よりも全体的な傾向に注目し、実行ごとの小さな変動を気にしすぎないでください。
別の方法を使う場面
統計的サンプリングが、すべての状況に最適とは限りません。
1 秒未満で完了する非常に短いスクリプトでは、信頼できる結果を得るのに十分なサンプルを集められないことがあります。
代わりに profiling.tracing を使うか、スクリプトをループで繰り返し実行してプロファイリングの時間を延ばしてください。
正確な呼び出し回数が必要な場合、サンプリングでは取得できません。
サンプリングはスナップショットから頻度を推定するため、関数が呼び出された正確な回数を知るには profiling.tracing を使ってください。
差が 1〜2% しかない可能性のある二つの実装を比較すると、サンプリングのノイズによって本当の差が見えなくなることがあります。
マイクロベンチマークには timeit を、精密な計測には profiling.tracing を使ってください。
profiling.tracing との主な違いは計測方法です。
トレース型プロファイラはコードの実行に計測処理を組み込み、すべての関数呼び出しと復帰を記録します。
正確な呼び出し回数と時間が得られますが、関数呼び出しごとにオーバーヘッドが生じます。
一方、サンプリングプロファイラは、プログラムの実行を変更せず、一定の間隔で外部から観測します。
トレースは誰かが後ろをついてきて一歩ずつ記録するようなもので、サンプリングは毎秒写真を撮り、その写真から移動経路を推測するようなものです。
この外部から観測する仕組みにより、サンプリングによるプロファイリングは本番環境でも実用的に使えます。 対象プログラムの内部で計測用のコードが動かないため、プログラムは通常の速度で動作し、サンプリング中に停止や一時停止もしません。 Tachyon はプロセスが実行を続けている間に、そのメモリからコールスタックを直接読み取ります。 アプリケーションに観測を意識させることなく、稼働中のサーバに接続し、データを収集して切断できます。 その代わり、非常に短い関数がサンプル間で完了した場合は、見逃すことがあります。
統計的プロファイリングは、「プログラムのどこに時間がかかっているか」を調べるのに優れています。
決定論的プロファイリングのオーバーヘッドを許容できない本番のコードでも、処理の集中箇所やボトルネックを明らかにできます。
正確な呼び出し回数や完全な呼び出しグラフには、代わりに profiling.tracing を使ってください。
簡単な使用例
スクリプトをプロファイルし、その場で結果を確認します。
python -m profiling.sampling run script.py
引数付きでモジュールをプロファイルします。
python -m profiling.sampling run -m mypackage.module arg1 arg2
対話的なフレームグラフを生成します。
python -m profiling.sampling run --flamegraph -o profile.html script.py
PID を指定して実行中のプロセスに接続します。
python -m profiling.sampling attach 12345
実行中のプロセスのスタックのスナップショットを一回表示します。
python -m profiling.sampling dump 12345
ライブモードでリアルタイムに監視します (終了するには q を押します)。
python -m profiling.sampling run --live script.py
サンプリングレートを上げて 60 秒間プロファイルします。
python -m profiling.sampling run -d 60 -r 20khz script.py
行ごとのヒートマップを生成します。
python -m profiling.sampling run --heatmap script.py
オペコード単位のプロファイリングを有効にして、実行中のバイトコード命令を確認します。
python -m profiling.sampling run --opcodes --flamegraph script.py
コマンド
Tachyon はいくつかのサブコマンドで操作します。
run と attach は一定期間サンプルを収集し、dump は一回のスナップショットを取得し、replay はバイナリ形式のプロファイルを別の形式に変換します。
run コマンド
run コマンドは Python スクリプトまたはモジュールを起動し、起動時からプロファイルします。
python -m profiling.sampling run script.py
python -m profiling.sampling run -m mypackage.module
スクリプトをプロファイルするときは、対象をサブプロセスとして起動し、初期化を待ってからサンプルの収集を開始します。
-m フラグは、対象をモジュールとして実行することを指定します (python -m と同等です)。
対象の後に指定した引数は、プロファイルするプログラムにそのまま渡されます。
python -m profiling.sampling run script.py --config settings.yaml
attach コマンド
attach コマンドは、プロセス ID を指定して、すでに実行中の Python プロセスに接続します。
python -m profiling.sampling attach 12345
このコマンドは、本番システムの性能問題を調査する際に特に役立ちます。 対象プロセスの変更も再起動も不要です。 プロファイラは接続後に指定した時間だけサンプルを収集し、その後切断して結果を出力します。
python -m profiling.sampling attach --live 12345
python -m profiling.sampling attach --flamegraph -d 30 -o profile.html 12345
ほとんどのシステムでは、別のプロセスに接続するには適切な権限が必要です。 プラットフォームごとの要件については プラットフォームの要件 を参照してください。
dump コマンド
dump コマンドは、トレースバックのような形式で、実行中のプロセスの Python スタックのスナップショットを一回表示して終了します。
python -m profiling.sampling dump 12345
attach と異なり、dump はサンプリングを繰り返さず、スタックを一度だけ読み取ります。
ハングしたプロセスや応答しないプロセスの調査、あるいは「このプロセスは今何をしているか」の確認に役立ちます。
出力はトレースバックと同じように、最後に直近の呼び出しを表示し、各スレッドに現在の状態を付記します (メインスレッド、GIL 保持中、CPU 上で実行中、GIL 待ち、例外あり、またはアイドル)。
Stack dump for PID 12345, thread 140735 (main thread, has GIL, on CPU; most recent call last):
  File "server.py", line 28, in serve
    await handle_request(req)
  File "handler.py", line 91, in handle_request
    result = expensive_call(req)
対象のソースファイルを読み取れる場合、dump は各フレームのソース行を表示し、実行中の式を強調表示します。
attach と同様に、dump には対象プロセスのメモリを読む権限が必要です。
プラットフォームの要件 を参照してください。
dump コマンドは次のオプションに対応しています。
-a,--all-threads対象プロセスのすべてのスレッドをダンプします。 このフラグを指定しなければ、メインスレッドだけを表示します。
--nativeC 拡張やその他の Python 以外のコードへの遷移を示す、人工的な
<native>フレームを含めます。--no-gcガベージコレクションの実行中であることを示す、人工的な
<GC>フレームを非表示にします。--opcodes各フレームに、スレッドが現在実行中のバイトコードのオペコードを付記します (例えば
opcode=CALL_KW)。 適応型インタープリタが選んだ特殊化の確認など、命令単位の調査に役立ちます。--async-awareawaitの境界をまたいでスタックを再構成します。dumpはタスクのグラフをたどり、タスクごとに一つの節を出力します。 待機関係にあるコルーチンの間は<task>マーカーで区切ります。--async-mode {running,all}--async-awareが有効なときに、どのタスクを含めるかを制御します。runningは各スレッドで現在実行中のタスクだけを表示し、all(dumpのデフォルト) は待機によって中断しているタスクも含めます。attachでは、このフラグのデフォルトはrunningです。 一回のスナップショットではタスクのグラフ全体を表示する方が役立つため、dumpのデフォルトはallになっています。--blockingスタックを読み取る間は対象の全スレッドを一時停止し、その後再開します。 対象が短時間止まる代わりに、完全に整合したスナップショットを保証します。 指定しない場合、
dumpは対象が動作したままメモリを読み取ります。 その方が高速ですが、まれに不整合のあるスタックが得られることがあります。
replay コマンド
replay コマンドは、バイナリ形式のプロファイルファイルを別の出力形式に変換します。
python -m profiling.sampling replay profile.bin
python -m profiling.sampling replay --flamegraph -o profile.html profile.bin
このコマンドは、バイナリ形式で取得したプロファイリングデータを後から分析したり、可視化用の形式に変換したりする際に役立ちます。 バイナリ形式のプロファイルは、再度プロファイリングを行わずに、何度でも別の形式で再生できます。
# バイナリから pstats に変換します (デフォルトでは標準出力に表示)
python -m profiling.sampling replay profile.bin

# バイナリからフレームグラフに変換します
python -m profiling.sampling replay --flamegraph -o output.html profile.bin

# バイナリから Firefox Profiler 用の gecko 形式に変換します
python -m profiling.sampling replay --gecko -o profile.json profile.bin

# バイナリからヒートマップに変換します
python -m profiling.sampling replay --heatmap -o my_heatmap profile.bin
本番環境でのプロファイリング
サンプリングプロファイラは、本番環境での使用を想定して設計されています。 コードに計測処理を組み込む代わりに外部からメモリを読むため、対象プロセスに測定できるほどのオーバーヘッドを与えません。 対象アプリケーションは通常の速度で動作を続け、プロファイルされていることを意識せずに動作します。
本番システムをプロファイルするときは、次の指針を参考にしてください。
最初は短時間 (10〜30 秒) で結果を確認し、統計的な精度がさらに必要なら時間を延ばしてください。 デフォルトでは対象プロセスが終了するまでプロファイリングを続けますが、通常はそれで主な処理の集中箇所を特定できます。
可能なら、アクセスが最も集中する時間帯ではなく、通常を代表する負荷の下でプロファイルしてください。 通常の動作中に収集したプロファイルは、異常な負荷の急増時に収集したものより解釈しやすくなります。
The profiler itself consumes some CPU on the machine where it runs (not on the target process). On the same machine, this is typically negligible. When profiling remote processes, network latency does not affect the target.
本番環境ではデータ量、同時実行の負荷、キャッシュの影響が異なるため、開発環境とは違う結果になる場合があります。 これは想定されることで、多くの場合、まさに捉えたい違いです。
プラットフォームの要件
プロファイラは対象プロセスのメモリを読み取り、スタックトレースを取得します。 ほとんどの OS では、そのために追加の権限が必要です。
Linux
Linux では、プロファイラは ptrace または process_vm_readv で対象プロセスのメモリを読み取ります。
通常、次のいずれかが必要です。
root として実行する
CAP_SYS_PTRACEケーパビリティを持つYama の ptrace スコープ
/proc/sys/kernel/yama/ptrace_scopeを調整する
デフォルトの ptrace_scope は 1 で、ptrace を実行できるのは親プロセスに限られます。 同じユーザが所有する任意のプロセスへ接続できるようにするには、0 に設定します。
echo 0 | sudo tee /proc/sys/kernel/yama/ptrace_scope
macOS
macOS では、プロファイラは task_for_pid() で対象プロセスにアクセスします。
次のいずれかが必要です。
root として実行する
プロファイラのバイナリが
com.apple.security.cs.debuggerエンタイトルメントを持つシステム整合性保護 (SIP) が無効になっている (非推奨)
Windows
Windows では、別のプロセスのメモリを読むために、プロファイラに管理者権限または SeDebugPrivilege 特権が必要です。
バージョンの互換性
プロファイラと対象プロセスは、同じ Python マイナーバージョン (例えば、どちらも Python 3.15) で実行する必要があります。 Python 3.14 から Python 3.15 のプロセスに接続することはできません。
プレリリースの Python バージョンには、さらに制限があります。 プロファイラか対象のいずれかがプレリリース (アルファ、ベータ、リリース候補) の場合、両方のバージョンが完全に一致していなければなりません。
フリースレッドの Python ビルドから標準のビルドに接続することや、その逆の接続はできません。
サンプリングの設定
出力形式や可視化の機能を見ていく前に、サンプリング処理自体の設定方法を理解しておくことが重要です。 プロファイラには、サンプルを収集する頻度、プロファイリングを続ける時間、観測するスレッド、各サンプルに記録する追加情報を制御するオプションがあります。
ほとんどの用途では、デフォルトの設定で十分です。
オプション |
デフォルト |
|---|---|
|
1 kHz |
|
完了まで実行 |
|
メインスレッドのみ |
|
|
|
ガベージコレクションの実行中は |
|
実時間モード (すべてのサンプルを記録) |
|
無効 |
|
無効 |
|
無効 (非ブロッキングのサンプリング) |
サンプリングレートと計測時間
最も基本的な二つの引数は、サンプリングレートと計測時間です。 この組み合わせで、プロファイリング中に収集するサンプル数が決まります。
--sampling-rate オプション (-r) は、サンプルを収集する頻度を指定します。
デフォルトは 1 kHz (毎秒 1,000 サンプル) です。
python -m profiling.sampling run -r 20khz script.py
レートを上げると、より多くのサンプルと細かなデータを得られますが、プロファイラの CPU 使用率が少し高くなります。 レートを下げるとプロファイラのオーバーヘッドは減りますが、短時間で終わる関数を見逃す可能性があります。 ほとんどのアプリケーションでは、デフォルトのレートが精度とオーバーヘッドのよいバランスになります。
--duration オプション (-d) は、プロファイルする時間を秒単位で指定します。
デフォルトでは、対象プロセスが終了するか中断されるまで続けます。
python -m profiling.sampling run -d 60 script.py
計測時間の指定は、長時間動作するプロセスに接続する場合や、特定の時間帯に限ってプロファイルしたい場合に便利です。 スクリプトをプロファイルする場合は、デフォルトの完了まで実行する動作が通常は適しています。
スレッドの選択
Python プログラムは、threading モジュールで明示的に、またはスレッドプールを管理するライブラリを通して暗黙的に、複数のスレッドを使うことがよくあります。
デフォルトでは、プロファイラはメインスレッドだけをサンプリングします。
--all-threads オプション (-a) を使うと、プロセス内のすべてのスレッドをサンプリングできます。
python -m profiling.sampling run -a script.py
複数スレッドのプロファイリングでは、スレッド間の処理の分担を確認し、ブロックしているスレッドや実行機会を得られないスレッドを特定できます。 各スレッドのサンプルはまとめて出力され、一部の形式ではスレッドごとに絞り込めます。 このオプションは、並行処理の問題を調べる場合や、スレッドプールに処理を分散している場合に特に便利です。
ブロッキングモード
デフォルトでは、Tachyon は対象プロセスを止めずにメモリを読み取ります。 この非ブロッキング方式は、対象アプリケーションのオーバーヘッドがほぼゼロであるため、ほとんどのプロファイリング用途に適しています。 対象プログラムは通常の速度で動作し、観測されていることを意識せずに実行を続けます。
ただし、yield 箇所を高速に切り替えるジェネレーターやコルーチンを多数使うアプリケーションでは、非ブロッキングのサンプリングで不完全または不整合なスタックトレースが得られることがあります。 また、コールスタックの変化が非常に速く、一回のスタック読み取りの開始から終了までの間に関数が呼び出されて復帰するプログラムでも同様です。 その結果、異なる実行状態のフレームが混在したスタックや、実際には存在しなかったスタックが再構成される場合があります。
このような場合には、--blocking オプションで、各サンプルの取得中に対象プロセスを止められます。
python -m profiling.sampling run --blocking script.py
python -m profiling.sampling attach --blocking 12345
ブロッキングモードを有効にすると、プロファイラは対象プロセスを一時停止し、スタックを読み取ってから再開します。 これにより、取得する各スタックが、その瞬間のプロセスの動作を表す実在の整合したスナップショットであることを保証します。 その代わり、一時停止が繰り返されるため、対象プロセスの動作は遅くなります。
警告
Do not use very high sample rates (low --interval values) with blocking
mode. Suspending and resuming a process takes time, and if the sampling
interval is too short, the target will spend more time stopped than running.
For blocking mode, intervals of 1000 microseconds (1 millisecond) or higher
are recommended. The default 100 microsecond interval may cause noticeable
slowdown in the target application.
ブロッキングモードは、プロファイルに不整合なスタックが見つかった場合、特にジェネレーターやコルーチンを多用するコードでのみ使ってください。 ほとんどのアプリケーションでは、デフォルトの非ブロッキングモードで、対象プロセスに影響を与えずに正確な結果が得られます。
特殊なフレーム
プロファイラは取得したスタックに人工的なフレームを挿入し、サンプル取得時にインタープリタが何をしていたかの情報を補足できます。 このフレームにより、通常は見えない実行の種類を区別できます。
--native オプションは、Python が C コード (拡張モジュール、組み込み関数、インタープリタ自体) を呼び出している箇所に <native> フレームを追加します。
python -m profiling.sampling run --native script.py
このフレームは、Python コードで使った時間とネイティブライブラリで使った時間を区別するのに役立ちます。 このオプションがなければ、ネイティブコードの実行時間は、それを呼び出した Python 関数の時間として表示されます。 NumPy やデータベースドライバーなどの C 拡張を多用するコードの最適化に便利です。
デフォルトでは、ガベージコレクションが実行中なら <GC> フレームを含めます。
--no-gc オプションは、このフレームを抑制します。
python -m profiling.sampling run --no-gc script.py
GC フレームは、ガベージコレクションに多くの時間を使うプログラムの特定に役立ちます。
そのようなプログラムでは、メモリ割り当てのパターンを最適化する価値があるかもしれません。
<GC> フレームに多くの時間が費やされていたら、オブジェクトの割り当て頻度の調査や、オブジェクトプールの利用を検討してください。
オペコードを考慮したプロファイリング
--opcodes オプションは、サンプルごとに実行中の Python バイトコード命令を記録する、命令単位のプロファイリングを有効にします。
python -m profiling.sampling run --opcodes --flamegraph script.py
この機能により、適応的特殊化による最適化を含む Python のバイトコード実行を確認できます。
LOAD_ATTR のような汎用の命令が、実行時に LOAD_ATTR_INSTANCE_VALUE のような効率的な命令へ特殊化されると、プロファイラは特殊化された名前と元の命令の両方を表示します。
オペコードの情報は、いくつかの出力形式に表示されます。
フレームグラフ: フレームにカーソルを合わせると、バイトコード命令の内訳を示すツールチップが表示され、その関数内でどのオペコードが時間を使ったかが分かります
ヒートマップ: ソース行ごとに展開できるバイトコードのパネルがあり、特殊化の割合を含む命令の内訳を表示します
ライブモード: キーボード操作で開けるオペコードパネルに、選択した関数の命令単位の統計を表示します
Gecko 形式: オペコードの切り替わりを、Firefox Profiler のタイムライン上の区間マーカーとして出力します
この詳しい情報は、特に次の用途に役立ちます。
Python の適応的特殊化が性能に与える影響を理解する
最適化が有効そうな、実行が集中するバイトコード命令を特定する
異なるコードの書き方の効果を命令単位で分析する
バイトコードのレベルで起こる性能問題をデバッグする
--opcodes オプションは、--live、--flamegraph、--heatmap、--gecko 形式と併用できます。
オペコード情報を保存するための追加メモリが必要で、サンプリングの性能が多少下がる場合もありますが、Python の実行モデルをこれまでにない詳しさで確認できます。
リアルタイムの統計
--realtime-stats オプションは、プロファイリング中にサンプリングレートの統計を表示します。
python -m profiling.sampling run --realtime-stats script.py
実際に達成したサンプリングレートを表示します。 プロファイラの処理が追いつかない場合、指定したレートを下回ることがあります。 この統計は、プロファイリングが正しく動作し、十分なサンプルが集まっているかを確認するのに役立ちます。 指標の読み方は サンプリング効率 を参照してください。
サブプロセスのプロファイリング
--subprocesses オプションは、対象が起動したサブプロセスの自動プロファイリングを有効にします。
python -m profiling.sampling run --subprocesses script.py
python -m profiling.sampling attach --subprocesses 12345
有効にすると、プロファイラは対象プロセスによる子プロセスの作成を監視します。
新しい Python 子プロセスを検出すると、それをプロファイルする別のプロファイラインスタンスを自動的に起動します。
multiprocessing、subprocess、ProcessPoolExecutor を使う concurrent.futures、その他のプロセス起動機構を利用するアプリケーションで便利です。
from concurrent.futures import ProcessPoolExecutor
import math

def compute_factorial(n):
    total = 0
    for i in range(50):
        total += math.factorial(n)
    return total

if __name__ == "__main__":
    numbers = [5000 + i * 100 for i in range(50)]
    with ProcessPoolExecutor(max_workers=4) as executor:
        results = list(executor.map(compute_factorial, numbers))
    print(f"Computed {len(results)} factorials")
python -m profiling.sampling run --subprocesses --flamegraph worker_pool.py
これにより、メインプロセスと各ワーカープロセスについて、flamegraph_<main_pid>.html、flamegraph_<worker1_pid>.html などの別々のフレームグラフが生成されます。
サブプロセスごとに出力ファイルが作成されます。 ファイル名は、指定した出力パス (またはデフォルト) にサブプロセスのプロセス ID を付けて決まります。
-o profile.htmlを指定すると、サブプロセスの出力はprofile_12345.html、profile_12346.htmlなどになりますデフォルトの出力では、サブプロセスごとに
flamegraph_12345.htmlのようなファイルやheatmap_12345のようなディレクトリが生成されますpstats 形式 (デフォルトの出力先は標準出力) では、サブプロセスの出力は
profile_12345.pstatsのようなファイルになります
サブプロセスのプロファイラは、親からほとんどのサンプリングオプションを引き継ぎます (サンプリングレート、計測時間、スレッドの選択、ネイティブフレーム、GC フレーム、非同期処理を考慮するモード、出力形式)。 孫プロセスやその先の子孫も含め、すべての Python 子孫プロセスを再帰的にプロファイルします。
サブプロセスの検出は、対象プロセスの新しい子孫を定期的に探し、新しい各プロセスのメモリに Python ランタイムの構造があるかを調べて、Python プロセスかどうかを確認します。 シェルコマンドや外部ツールなど、Python 以外のサブプロセスは無視します。
多数のプロセスを起動するプログラムでリソースが枯渇しないよう、同時に動作するサブプロセスのプロファイラは 100 個までに制限されています。 上限に達すると、それ以降のサブプロセスはプロファイルされず、警告を表示します。
--subprocesses オプションは --live モードと併用できません。
ライブモードは対話的な端末インターフェースを使い、複数のプロファイラの同時表示に対応できないためです。
サンプリング効率
サンプリング効率の指標は、収集したデータの品質を評価するのに役立ちます。 プロファイラの端末出力とフレームグラフのサイドバーに表示されます。
サンプリング効率 は、サンプル取得の試行のうち成功した割合です。 試行ごとに、対象プロセスのメモリからコールスタックを読み取ります。 コンテキストスイッチ中やインタープリタの内部構造の更新中など、読み取り時点でプロセスが不整合な状態にあると、取得に失敗することがあります。 効率が低い場合、システムの負荷や短すぎる間隔設定により、プロファイラが指定したサンプリングレートに追いついていない可能性があります。
取り逃したサンプル は、予定したサンプルのうち収集できなかった割合です。 設定した間隔と計測時間から、プロファイラは収集する予定のサンプル数を求めます。 システムの負荷が高い場合など、プロファイラが予定に追いつけないと、一部のサンプルを取り逃すことがあります。 少数の取り逃しは通常起こるもので、プロファイルの統計的な精度には大きく影響しません。
どちらの指標も参考情報です。 試行の失敗やサンプルの取り逃しが多少あっても、十分なサンプルを収集できていれば、プロファイルは統計的に有効です。 プロファイラは実際に取得したサンプル数を報告するので、分析に十分なデータがあるか判断できます。
プロファイリングモード
サンプリングプロファイラは、記録するサンプルを制御する四つのモードに対応しています。 モードによって、総経過時間、CPU 実行時間、グローバルインタープリタロックを保持した時間、例外処理のどれを測るかが決まります。
実時間モード
実時間モード (--mode=wall) は、スレッドが何をしているかに関係なく、すべてのサンプルを記録します。
これはデフォルトのモードで、プログラムの実行中にどこで時間が使われたかの全体像を示します。
python -m profiling.sampling run --mode=wall script.py
実時間モードでは、Python コードの実行中、I/O 待ち、ロック待ち、スリープ中のいずれでもサンプルを記録します。 そのため、待ち時間も含めたプログラム全体の時間配分を把握するのに適しています。
プログラムが I/O 処理、ネットワーク呼び出し、スリープに多くの時間を使う場合、実時間モードはその待ち時間を呼び出し元の関数の時間として表示します。 処理の開始から終了までの遅延を最適化する場合は、まさにこの情報が必要なことがよくあります。
CPU モード
CPU モード (--mode=cpu) は、スレッドが実際に CPU コア上で実行されている場合にだけサンプルを記録します。
python -m profiling.sampling run --mode=cpu script.py
スレッドがスリープ中、I/O 待ち、ロック待ちのときに取得したサンプルは破棄します。 得られるプロファイルはアイドル時間を除外し、CPU サイクルがどこで使われたかを示します。
CPU モードは、I/O 待ちの影響を受けずに計算の集中箇所へ注目したい場合に便利です。 プログラムが計算とネットワーク呼び出しを交互に行う場合、CPU モードはどの計算部分に最も時間がかかるかを示します。
実時間と CPU のプロファイルの比較
実時間モードと CPU モードの両方でプロファイルすると、関数が計算に時間を使っているのか、待機に使っているのかを判断できます。
両方のプロファイルで目立つ関数は、実際に CPU を使う計算の集中箇所です。 アルゴリズムの改善や、より効率的なコードへの変更を中心に最適化してください。
実時間モードでは大きな割合を占めるのに、CPU モードでは小さいか現れない関数は、I/O が律速になっているか、待機しています。 時間の大半をネットワーク、ディスク、ロック、スリープの待機に費やしています。 ここでは CPU 処理の最適化は役に立たないため、非同期 I/O、接続プール、待ち時間の削減を検討してください。
import time

def do_sleep():
    time.sleep(2)

def do_compute():
    sum(i**2 for i in range(1000000))

if __name__ == "__main__":
    do_sleep()
    do_compute()
python -m profiling.sampling run --mode=wall script.py  # do_sleep は約98%、do_compute は約1%
python -m profiling.sampling run --mode=cpu script.py   # do_sleep は現れず、do_compute が大半を占めます
GIL モード
GIL モード (--mode=gil) は、スレッドが Python のグローバルインタープリタロックを保持している場合にだけサンプルを記録します。
python -m profiling.sampling run --mode=gil script.py
The GIL is held only while executing Python bytecode. When Python calls into C extensions, performs I/O operations, or executes native code, the GIL is typically released. This means GIL mode effectively measures time spent running Python code specifically, filtering out time in native libraries.
マルチスレッドのプログラムでは、GIL モードにより、ほかのスレッドによる Python バイトコードの実行を妨げているコードが分かります。 同時に GIL を保持できるスレッドは一つだけなので、GIL モードのプロファイルに頻繁に現れる関数はインタープリタを独占しています。
GIL モードは、「どの関数が GIL を独占しているか」「なぜほかのスレッドが実行機会を得られないか」を調べるのに役立ちます。 シングルスレッドのプログラムでも、Python の実行時間と C 拡張や I/O の時間を区別するのに役立つ場合があります。
import hashlib

def hash_work():
    # C 拡張: 計算中は GIL を解放します
    for _ in range(200):
        hashlib.sha256(b"data" * 250000).hexdigest()

def python_work():
    # 純粋な Python: 計算中は GIL を保持します
    for _ in range(3):
        sum(i**2 for i in range(1000000))

if __name__ == "__main__":
    hash_work()
    python_work()
python -m profiling.sampling run --mode=cpu script.py  # hash_work は約42%、python_work は約38%
python -m profiling.sampling run --mode=gil script.py  # hash_work は約5%、python_work は約60%
例外モード
例外モード (--mode=exception) は、スレッドで例外が送出または処理されている場合にだけサンプルを記録します。
python -m profiling.sampling run --mode=exception script.py
サンプルが記録されるのは、例外がコールスタックを上へ伝播している間 (raise の後、捕捉される前) と、例外情報がスレッド状態に残っている except ブロック内のコードを実行している間の二つの場合です。
次の例で、どのコード領域が記録されるかを示します。
def example():
    try:
        raise ValueError("error")    # 記録対象: 例外の送出中
    except ValueError:
        process_error()              # 記録対象: except ブロック内
    finally:
        cleanup()                    # 対象外: 例外は処理済み

def example_propagating():
    try:
        try:
            raise ValueError("error")
        finally:
            cleanup()                # 記録対象: 例外が伝播中
    except ValueError:
        pass

def example_no_exception():
    try:
        do_work()
    finally:
        cleanup()                    # 対象外: 例外なし
finally ブロックが記録されるのは、そのブロックを例外が伝播している場合だけです。
except ブロックの実行が終わると、Python は後続の finally ブロックを実行する前に例外情報を消去します。
同様に、例外が発生していない通常の実行で通る finally ブロックは、例外状態がないため記録されません。
このモードは、プログラムがエラー処理のどこに時間を使っているかを把握するのに便利です。
イテレーターの StopIteration のように例外で処理の流れを制御するコードや、接続失敗を処理するネットワークサーバのように多くのエラー状態を扱うアプリケーションでは、例外処理が大きなオーバーヘッドの原因になることがあります。
例外モードは、「例外処理にどれだけ時間を使っているか」「どの例外ハンドラーに最も時間がかかるか」を調べるのに役立ちます。 例外を適切に処理している場合でも、多数の例外を捕捉して処理するコードに隠れた性能上のコストを明らかにできます。 例えば、解析ライブラリが内部で形式の誤りを例外で通知する場合、呼び出し側に例外が見えなくても、このモードはハンドラー内で使った時間を記録します。
出力形式
プロファイラは、分析の進め方に応じた複数の形式で出力できます。 コマンドラインのフラグで形式を選び、その形式に応じて標準出力、ファイル、ディレクトリのいずれかへ出力します。
pstats 形式
pstats 形式 (--pstats) は、決定論的プロファイラの出力に似たテキストの表を生成します。
これがデフォルトの出力形式です。
python -m profiling.sampling run script.py
python -m profiling.sampling run --pstats script.py
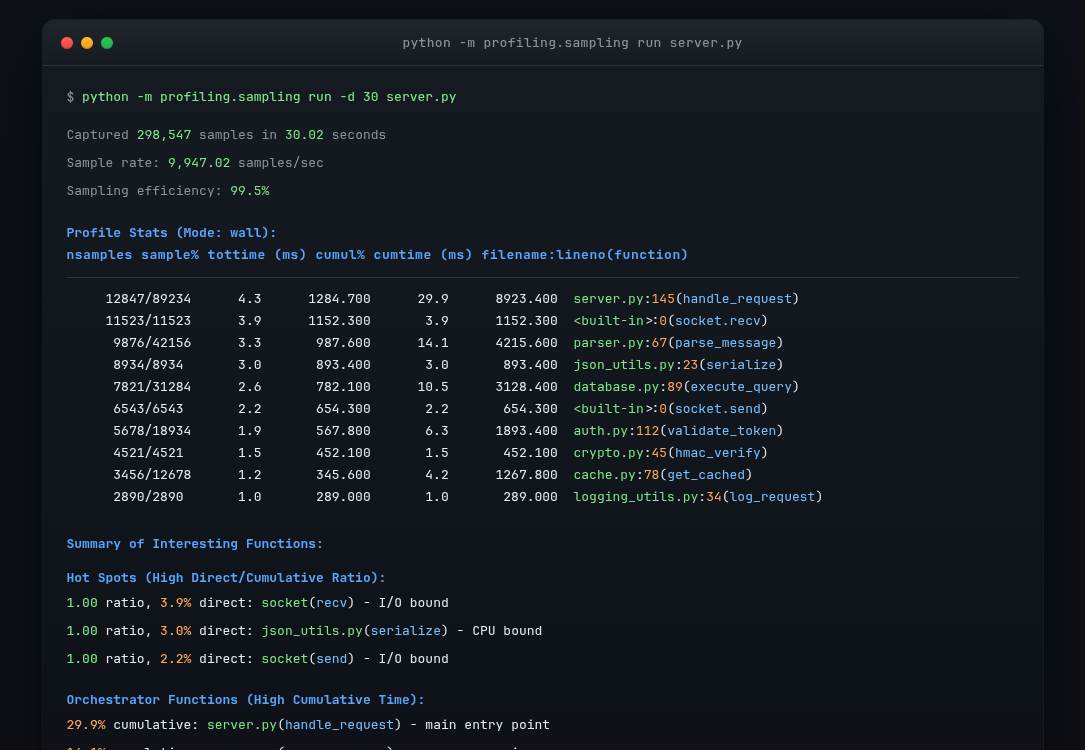
pstats 形式は、処理の集中する関数、サンプル数、推定時間を色分けした表で表示します。
デフォルトでは標準出力に表示します。
Profile Stats (Mode: wall):
     nsamples  sample%    tottime (ms)  cumul%   cumtime (ms)  filename:lineno(function)
       234/892    11.7%       234.00     44.6%       892.00    server.py:145(handle_request)
       156/156     7.8%       156.00      7.8%       156.00    <built-in>:0(socket.recv)
        98/421     4.9%        98.00     21.1%       421.00    parser.py:67(parse_message)
各列はサンプル数と推定時間を示します。
nsamples:
direct/cumulativeの形で表示します (例えば10/50)。 直接サンプルは、その関数がスタックの最上部にあり、実行中だったサンプルです。 累積サンプルは、その関数がスタックのどこかに現れたサンプルで、呼び出し先の関数を待っていた場合も含みます。10/50なら、10 個のサンプルでその関数自身が実行中であり、合計 50 個のサンプルでコールスタックに存在していたことを表します。sample% と cumul%: 総サンプル数に対する、直接サンプル数と累積サンプル数それぞれの割合です。
tottime と cumtime: サンプル数とプロファイリングの計測時間に基づく実時間の推定値です。 時間の単位は値の大きさに応じて自動的に選ばれ、大きな値には秒、中程度にはミリ秒、小さな値にはマイクロ秒を使います。
出力には、各列の説明と、次の特徴を持つ関数を取り上げた概要が含まれます。
Hot spots: Functions with high direct/cumulative sample ratio (ratio close to 1.0). These functions spend most of their time executing their own code rather than waiting for callees. High ratios indicate where CPU time is actually consumed.
間接呼び出し: 累積サンプル数と直接サンプル数の差が大きい関数です。 処理をほかの関数に委ねて全体を調整する関数で、スタックには頻繁に現れますが、最上部に現れることはまれです。
呼び出しの倍率: 累積サンプル数が直接サンプル数を大きく上回る関数です (累積/直接の倍率が高い関数)。 多くの呼び出しの連鎖の深い位置に現れ、頻繁に入れ子になる関数です。
--no-summary を指定すると、列の説明と概要の両方を非表示にします。
pstats の出力を標準出力ではなくバイナリファイルに保存するには、次のようにします。
python -m profiling.sampling run -o profile.pstats script.py
pstats 形式には、表示を制御するオプションがいくつかあります。
--sort オプションは、結果の並べ替えに使う列を指定します。
python -m profiling.sampling run --sort=tottime script.py
python -m profiling.sampling run --sort=cumtime script.py
python -m profiling.sampling run --sort=nsamples script.py
--limit オプションは、出力を上位 N 件に制限します。
python -m profiling.sampling run --limit=30 script.py
--no-summary オプションは、統計表の前に表示するヘッダーの概要を抑制します。
集約スタック形式
集約スタック形式 (--collapsed) は、異なるコールスタックごとに一行を出力し、そのスタックが何回サンプリングされたかを併記します。
python -m profiling.sampling run --collapsed script.py
出力は次のようになります。
main;process_data;parse_json;decode_utf8 42
main;process_data;parse_json 156
main;handle_request;send_response 89
各行には、コールスタックを下から上へ表す、セミコロンで区切った関数名が並び、その後にスペースとサンプル数が続きます。
この形式は、外部のフレームグラフツール、特に Brendan Gregg の flamegraph.pl スクリプトとの互換性を目的としています。
集約スタックからフレームグラフを生成するには、次のようにします。
python -m profiling.sampling run --collapsed script.py > stacks.txt
flamegraph.pl stacks.txt > profile.svg
生成した SVG はどの Web ブラウザーでも表示でき、特定の呼び出し経路をクリックして拡大できる対話的な可視化になっています。
フレームグラフ形式
フレームグラフ形式 (--flamegraph) は、対話的なフレームグラフを含む、単独で動作する HTML ファイルを生成します。
python -m profiling.sampling run --flamegraph script.py
python -m profiling.sampling run --flamegraph -o profile.html script.py
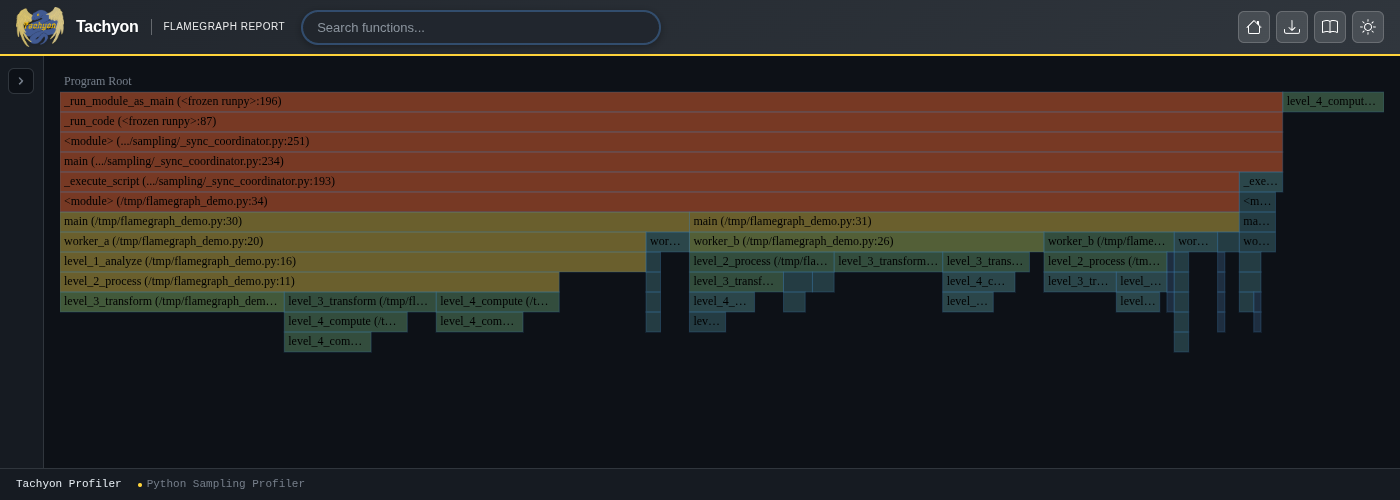
フレームグラフは、コールスタックを入れ子の長方形で示し、幅は費やした時間に比例します。 サイドバーには、実行時の統計、GIL の指標、処理の集中する関数を表示します。
対話的な使用例 を試してください。
If no output file is specified, the profiler generates a filename based on
the process ID (for example, flamegraph.12345.html).
生成した HTML ファイルは外部の依存関係を必要とせず、Web ブラウザーで直接開けます。 コールスタックは入れ子の長方形で表示され、幅は費やした時間に比例します。 長方形にカーソルを合わせると、前後のソースコードを含む関数の詳細が表示され、クリックすると呼び出しツリーのその部分を拡大します。
フレームグラフのインターフェースには、次の機能があります。
プロファイルの概要、スレッドの統計、サンプリング効率の指標 (サンプリング効率 を参照)、処理が集中する上位の関数を表示するサイドバー
関数名と
file.py:42のような行指定の両方に対応する検索機能ドロップダウンによるスレッドごとの絞り込み
ダーク/ライトテーマの切り替え (設定はセッション間で保存されます)
現在の表示を保存する SVG エクスポート
スレッド統計の欄には、実行時の動作に関する指標を表示します。
GIL Held: percentage of samples where a thread held the global interpreter lock (actively running Python code)
GIL Released: percentage of samples where no thread held the GIL
Waiting GIL: スレッドが GIL の取得を待っていたサンプルの割合
GC: ガベージコレクション中のサンプルの割合
これらの統計は、GIL の競合を特定し、Python の実行、ネイティブコード、待機の間でどのように時間が使われているかを理解するのに役立ちます。
フレームグラフは、深いコールスタックの特定と、時間消費の階層構造の把握に特に効果的です。 上部の幅広い長方形は、自身の処理または呼び出し先の処理を通して、多くの時間を使う関数を示します。
差分フレームグラフ
差分フレームグラフは二回のプロファイリング結果を比較し、性能が変化した箇所を強調します。 コード変更による性能低下を特定したり、最適化が意図した効果を得られたか確認したりするのに役立ちます。
# 基準となるプロファイルを取得します
python -m profiling.sampling run --binary -o baseline.bin script.py

# コード変更後に差分フレームグラフを生成します
python -m profiling.sampling run --diff-flamegraph baseline.bin -o diff.html script.py
現在のプロファイルを、現在の時間消費を表すフレーム幅で描き、基準と比べた各関数の変化を色で示します。
色分け:
赤: 時間が増えた関数 (性能低下)。 薄い色は小さな増加、濃い色は大幅な性能低下を表します。
青: 時間が減った関数 (改善)。 薄い色は小さな削減、濃い色は大幅な高速化を表します。
灰色: 変化がほとんどないか、まったくありません。
紫: 基準のプロファイルにはなかった新しい関数です。
フレームの色は、呼び出し先を含む累積時間ではなく、直接時間 (その関数がスタックの最上部で実行されていた時間) の変化を示します。 フレームにカーソルを合わせると、基準の時間、現在の時間、変化率などの比較の詳細を表示します。
プロファイル間で、呼び出し経路が完全になくなることがあります。 これは 消えたスタック (elided stacks) と呼ばれ、最適化でコード経路が除去された場合や、特定の分岐が実行されなくなった場合に生じます。 消えたスタックがあると切り替えボタンが現れ、通常の差分表示と、削除された経路だけを紫色で示す表示を切り替えられます。
Gecko 形式
Gecko 形式 (--gecko) は、Firefox Profiler と互換性のある JSON を出力します。
python -m profiling.sampling run --gecko script.py
python -m profiling.sampling run --gecko -o profile.json script.py
Firefox Profiler は、もともと Firefox 自体をプロファイルするために作られた、高機能な Web ベースのツールです。 基本的なフレームグラフ以外にも、タイムライン表示、呼び出しツリーの探索、マーカーの可視化などの機能を提供します。 詳しい使い方は Firefox Profiler のドキュメント を参照してください。
出力を使うには、ブラウザーで Firefox Profiler を開き、JSON ファイルを読み込みます。 プロファイラはすべてクライアント側で動作するため、プロファイリングデータがマシンの外へ送られることはありません。
Gecko 形式は、GIL の状態や CPU の動作に関する追加のメタデータを自動で収集し、Python のスレッドモデルに特有の分析を可能にします。 プロファイラは区間マーカーを出力し、Firefox Profiler のタイムライン上で色付きの帯として表示します。
GIL マーカー: スレッドがグローバルインタープリタロックを保持または解放している期間を示します
CPU マーカー: スレッドが CPU 上で実行中か、アイドル状態かを示します
コード種別マーカー: Python コードとネイティブコード (C 拡張) を区別します
GC マーカー: ガベージコレクションの動作を示します
このため、Gecko 形式では --mode オプションを使えません。
関連するデータはすべて自動で取得します。
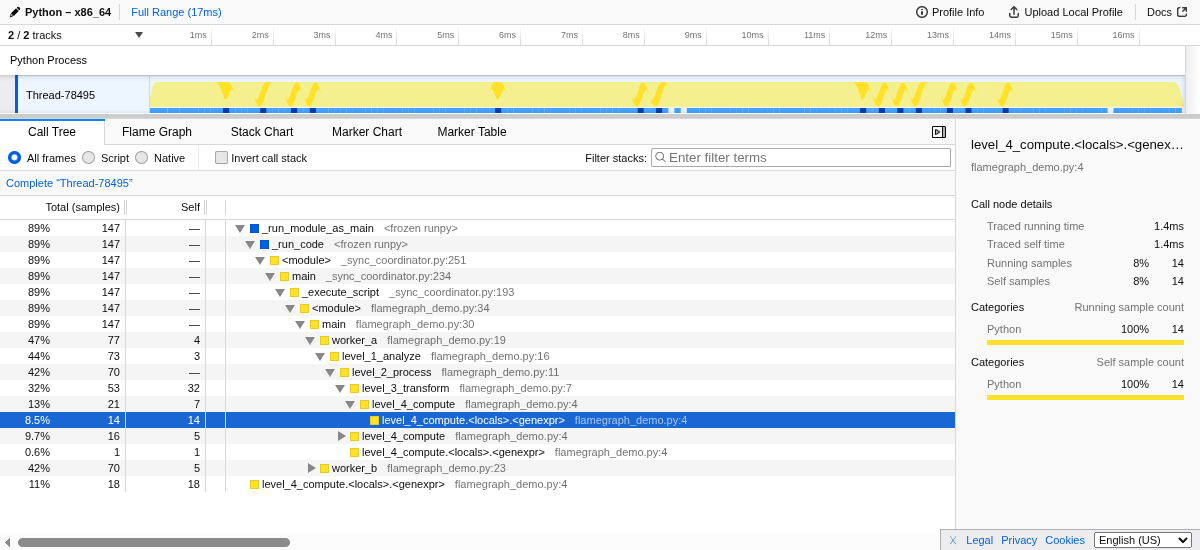
Call Tree ビューは、サンプル数と割合とともに呼び出し階層全体を表示します。 サイドバーには、実行時間やサンプルの分布など、選択した関数の詳しい統計を表示します。
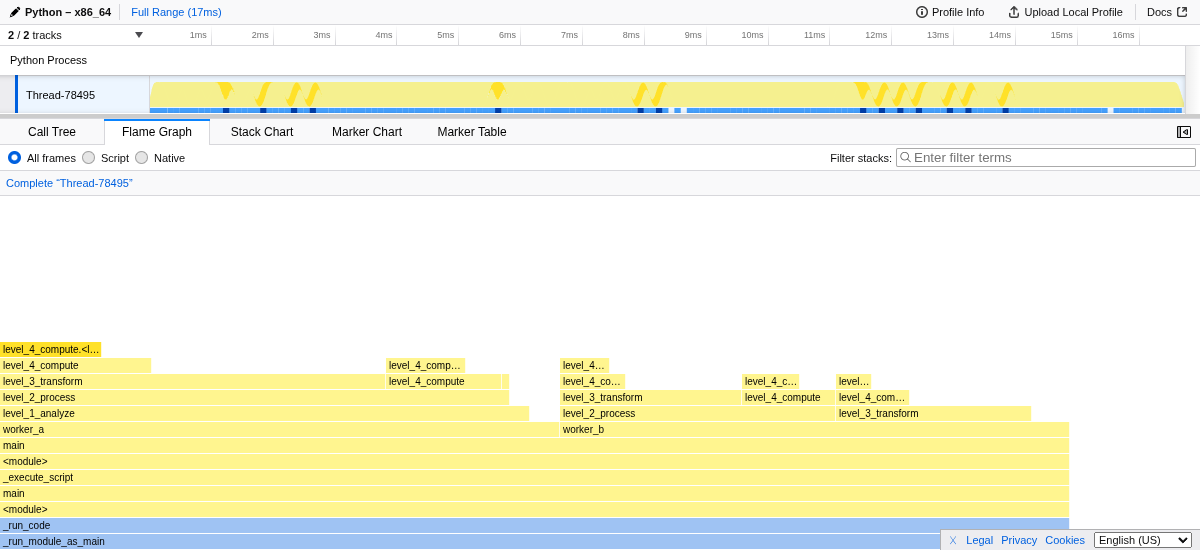
Flame Graph ビューは、コールスタックを入れ子の長方形で表示します。 呼び出し階層の中に関数名が表示されます。
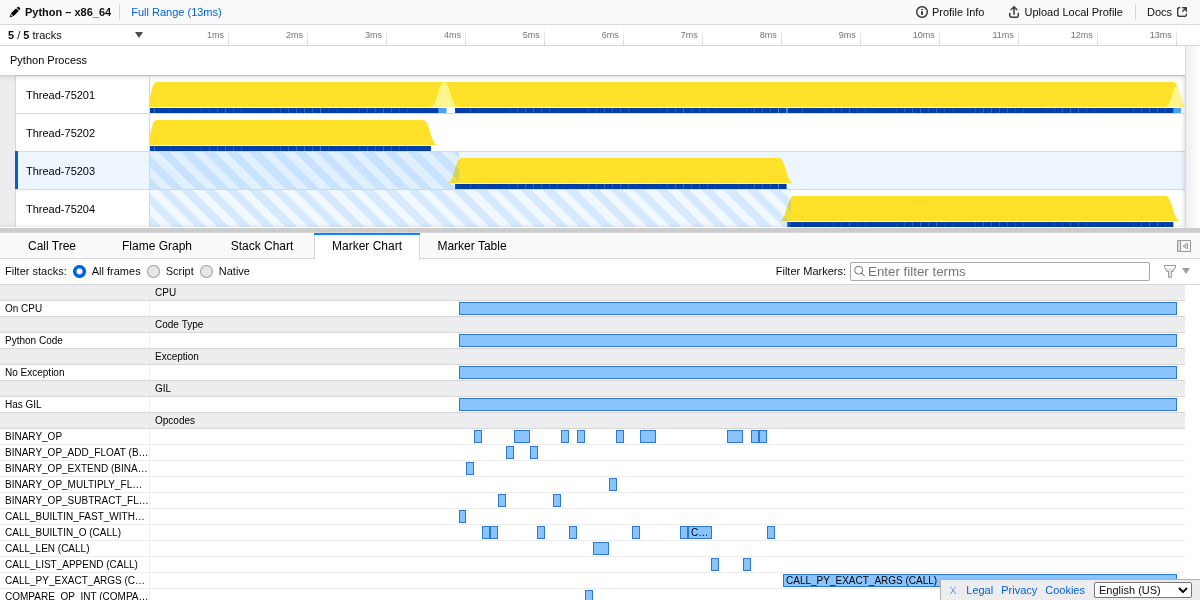
Marker Chart は、CPU の状態、GIL の状態、オペコードなどの区間マーカーを表示します。
--opcodes を有効にすると、BINARY_OP_ADD_FLOAT、CALL_PY_EXACT_ARGS、CALL_LIST_APPEND などのバイトコード命令が、時間に沿った実行を示すマーカーとして現れます。
ヒートマップ形式
ヒートマップ形式 (--heatmap) は、ソース行単位のサンプル数を表示する、対話的な HTML の可視化を生成します。
python -m profiling.sampling run --heatmap script.py
python -m profiling.sampling run --heatmap -o my_heatmap script.py
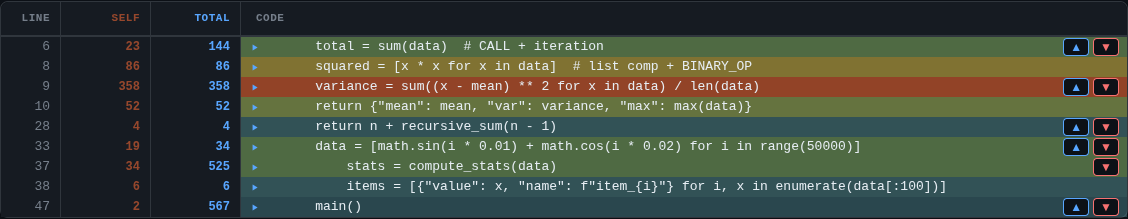
ヒートマップは、ソースコードにサンプル数を直接重ねて表示します。 サンプルが少ない行は寒色、多い行は暖色で色分けします。 移動ボタン (▲▼) で呼び出し元と呼び出し先の間を移動できます。
単一ファイルを生成するほかの形式と異なり、ヒートマップ出力は、プロファイルした各ソースファイルの HTML ファイルを含むディレクトリを作成します。
出力パスを指定しなければ、ディレクトリ名は heatmap_PID になります。
ヒートマップはソースコードを表示し、各行で収集したサンプル数を色の濃淡で示します。 サンプルの多い行は暖色、少ない行やサンプルのない行は寒色で表示します。 この表示は、時間の消費につながっているコードの行を正確に特定するのに役立ちます。
ヒートマップのインターフェースには、いくつかの対話的な機能があります。
色分けモード: "Self Time" (直接の実行時間) と "Total Time" (呼び出し先の関数の時間を含む累積時間) を切り替えます
サンプルのないコードの絞り込み: すべての行を表示するか、サンプルのある行だけを表示するかを選べます
呼び出しグラフの移動: 各行の移動ボタン (呼び出し元は ▲、呼び出し先は ▼) で、コード内の実行経路をたどれます。 その行を呼び出した関数、またはその行から呼び出した関数が複数ある場合は、サンプル数付きの一覧メニューが表示されます。
スクロール用ミニマップ: ファイル全体でサンプルが集中する箇所を示す縦長の概観表示
階層型インデックス: 種類別 (stdlib、site-packages、project) に整理したファイル一覧と、フォルダーごとの合計サンプル数
ダーク/ライトテーマ: テーマを切り替えられ、設定はセッション間で保存されます
行へのリンク: 行番号をクリックすると、共有できる URL を作成します
--opcodes でオペコード単位のプロファイリングを有効にすると、サンプルのある各行を展開し、どのバイトコード命令が時間を使ったかを確認できます。
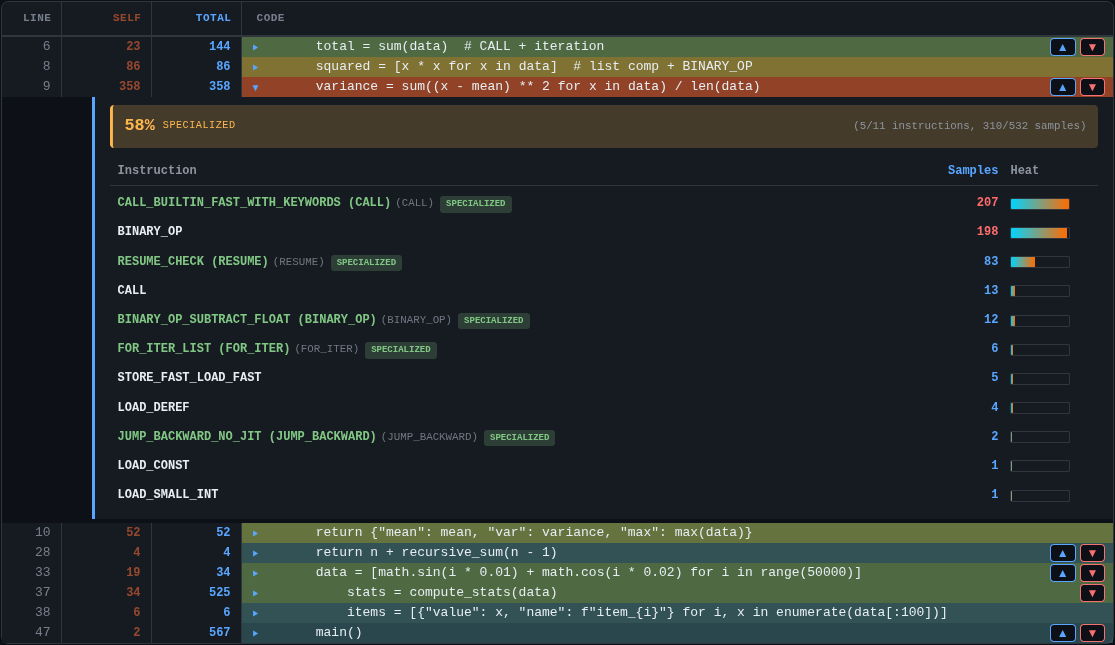
サンプルの多い行を展開すると、特殊化された命令も含め、実行されたバイトコード命令が表示されます。 パネルには、命令ごとのサンプル数と、その行全体の特殊化の割合を示します。
対話的な使用例 を試してください。
ヒートマップは、性能の問題があるファイルは分かっていて、具体的な行を特定したい場合に特に便利です。 ソースコードに直接対応していて読み取りや移動が簡単なため、この形式を好む開発者も多くいます。 小さなスクリプトや範囲を絞った分析では、階層的な可視化を読み解かなくても、時間を費やしている箇所を直感的に把握できます。
バイナリ形式
バイナリ形式 (--binary) は、プロファイリングデータを効率的に保存するコンパクトなバイナリファイルを生成します。
python -m profiling.sampling run --binary -o profile.bin script.py
python -m profiling.sampling attach --binary -o profile.bin 12345
--compression オプションは、データの圧縮を制御します。
auto(デフォルト): zstd 圧縮を利用できれば使い、そうでなければ圧縮しませんzstd: zstd 圧縮を必ず使います (compression.zstdのサポートが必要です)none: 圧縮を無効にします
python -m profiling.sampling run --binary --compression=zstd -o profile.bin script.py
バイナリ形式のプロファイルを分析するには、replay コマンド でフレームグラフや pstats などの別形式に変換します。
記録と再生を使った作業手順
バイナリ形式と replay コマンドを組み合わせると、データの取得と分析を分けた、記録・再生による作業ができます。 プロファイリング中に可視化を生成する代わりに、生データをコンパクトなバイナリファイルに保存し、後からさまざまな形式に変換します。
この方法には、主に三つの利点があります。
可視化用のデータ構造を作る処理を再生時まで遅らせるため、サンプリングが速くなります。
一度取得したバイナリデータを、再度プロファイリングせずに複数の形式へ変換できます。 概要を手早く確認する pstats、視覚的に探索するフレームグラフ、行単位の詳細を見るヒートマップを使い分けられます。
バイナリファイルは小さく、同僚と共有しやすい形式です。 受け取った人は好みの形式に変換できます。
典型的な作業手順は次のとおりです。
# 本番環境やテスト中にプロファイルを取得します
python -m profiling.sampling attach --binary -o profile.bin 12345

# 後から別の形式で分析します
python -m profiling.sampling replay profile.bin
python -m profiling.sampling replay --flamegraph -o profile.html profile.bin
python -m profiling.sampling replay --heatmap -o heatmap profile.bin
ライブモード
ライブモード (--live) は、システムのプロセスを表示する top コマンドと同じように、端末上でプロファイリングデータをリアルタイムに表示します。
python -m profiling.sampling run --live script.py
python -m profiling.sampling attach --live 12345
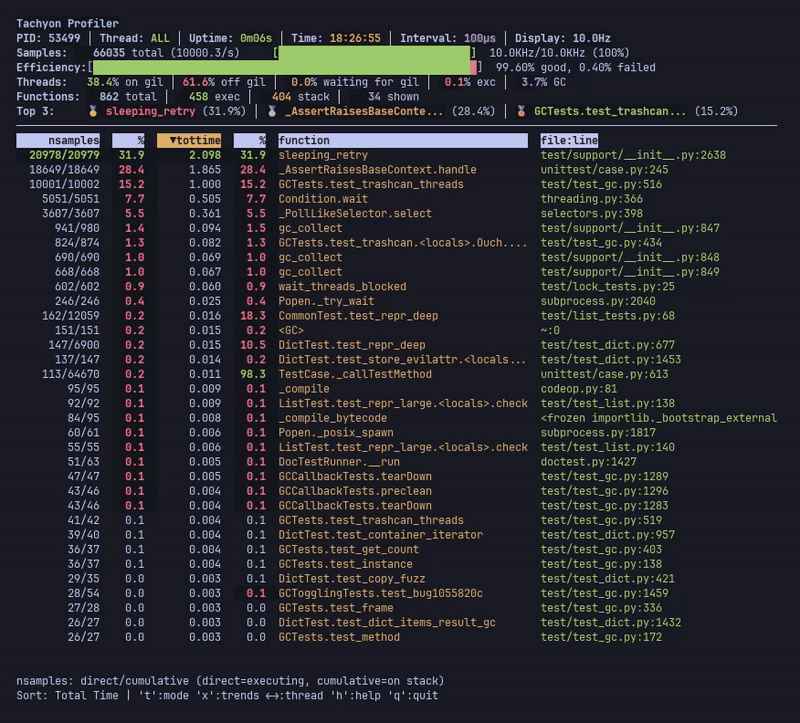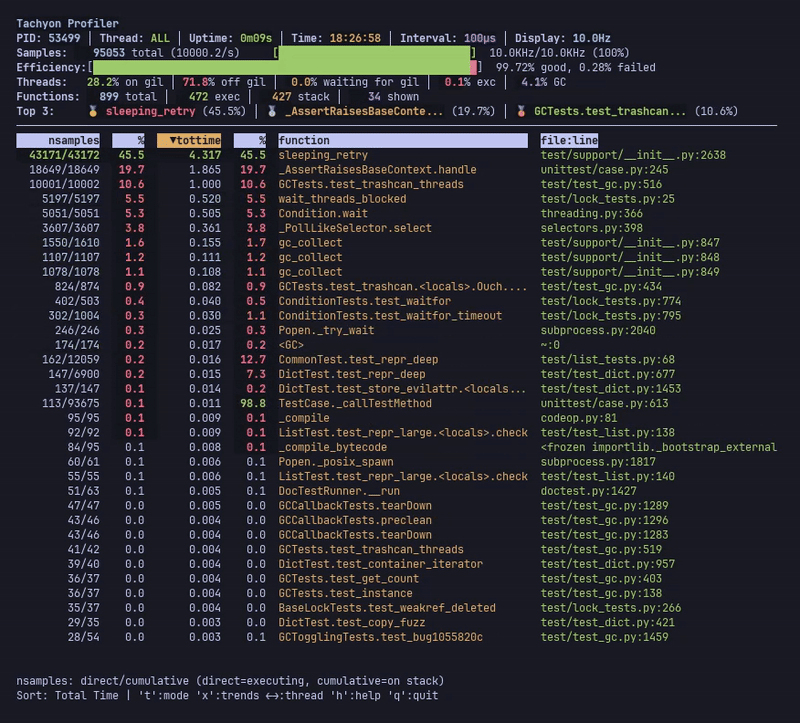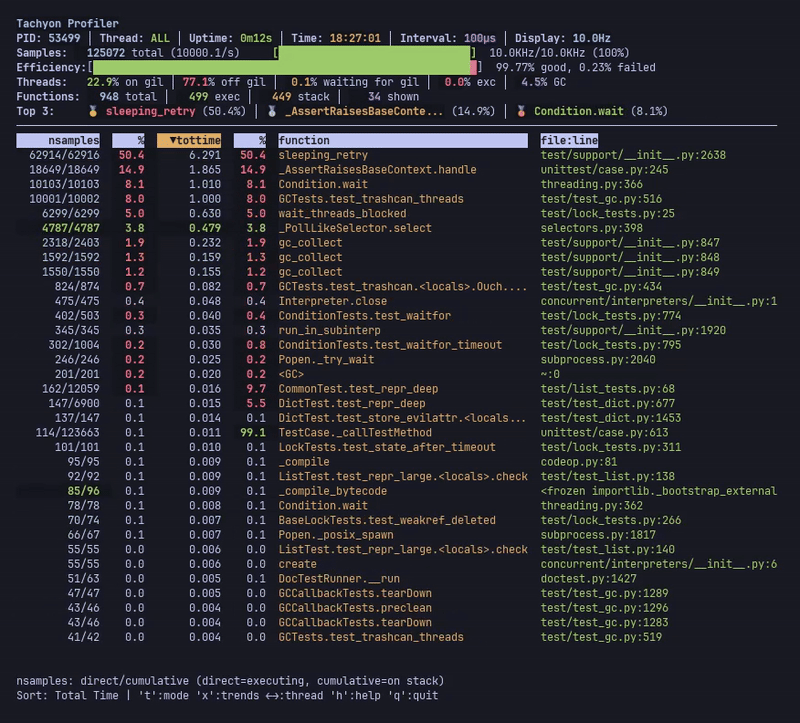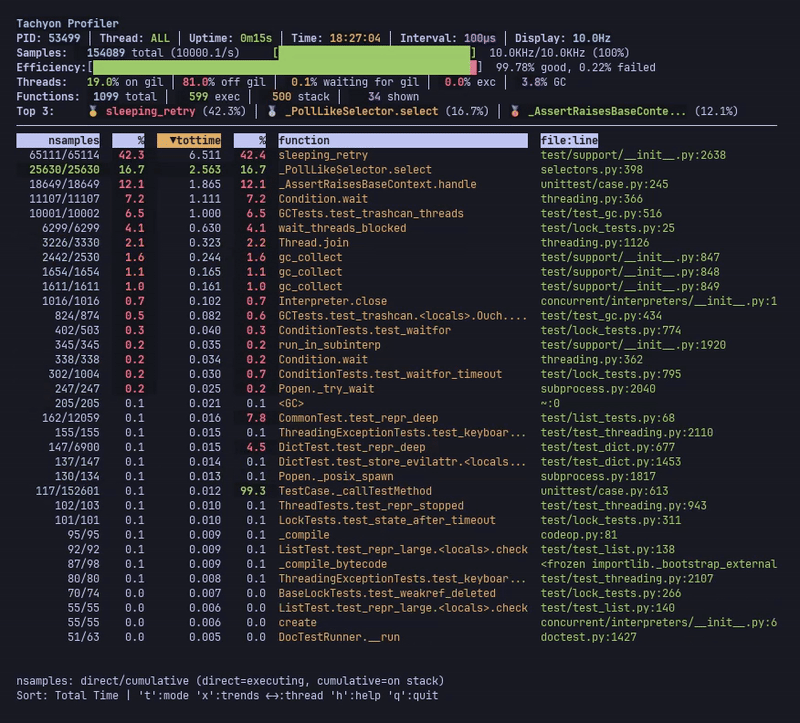
ライブモードはプロファイリング統計をリアルタイムに表示し、マルチスレッドのアプリケーションでは複数スレッドのデータをまとめて示します。
新しいサンプルが届くたびに表示を更新し、その時点で処理が最も集中する関数を示します。
このモードには curses モジュールが必要で、Unix 系のシステムでは使えますが、Windows では使えません。
端末は幅 60 桁、高さ 12 行以上が必要です。
大きな端末では、より多くの列を表示します。
ヘッダーには、処理が集中する上位 3 関数、サンプリング効率の指標、スレッド状態の統計 (GIL 保持率、CPU 使用率、GC 時間) を表示します。 主な表には関数の統計を表示し、現在のソート対象の列を矢印 (▼) で示します。
--opcodes を有効にすると、表の下にオペコードパネルが追加され、現在選択している関数の命令単位の統計を表示します。
このパネルには、特殊化された命令とその元のオペコードも含め、どのバイトコード命令が最も頻繁に実行されているかを表示します。
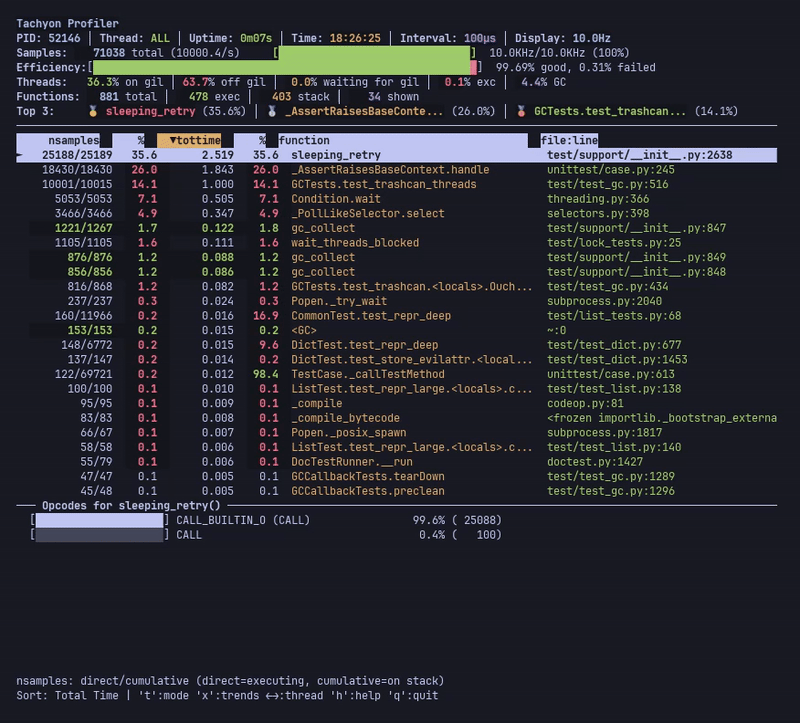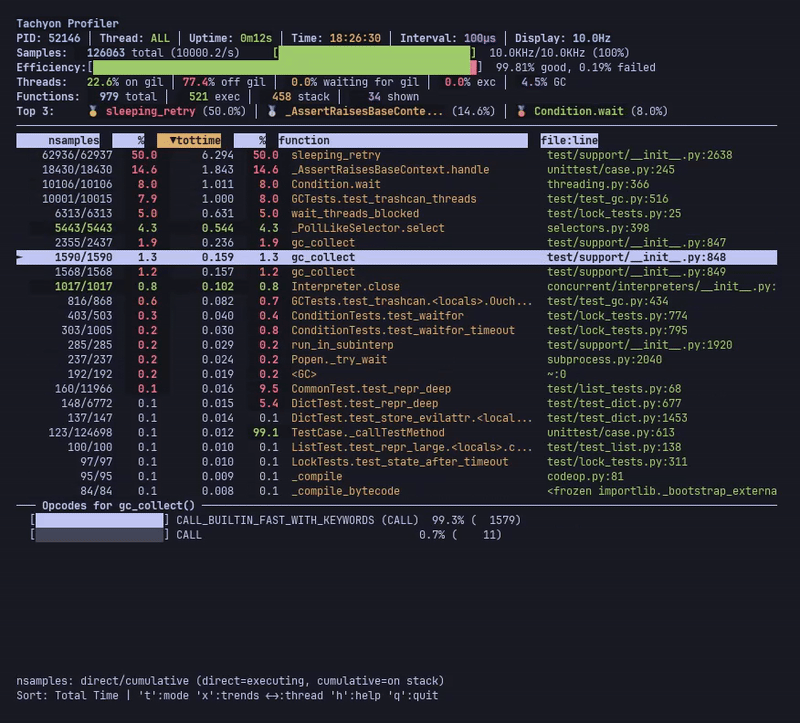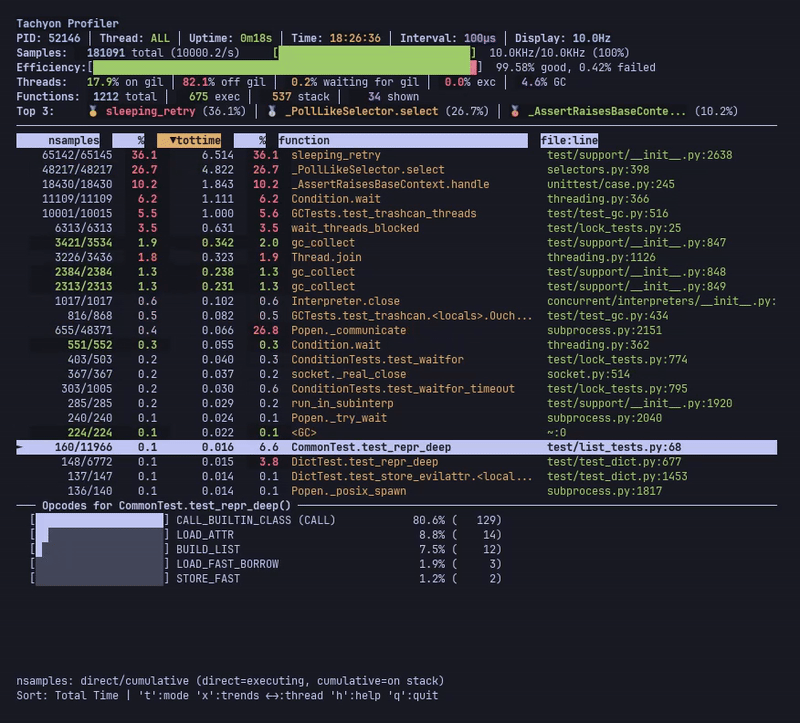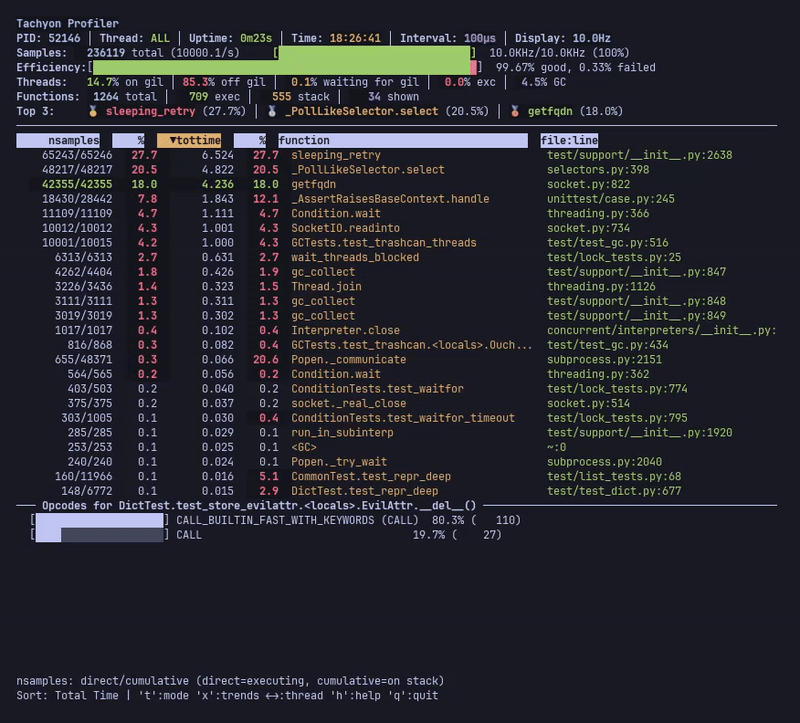
--opcodes を有効にしたライブモードでは、選択した関数のバイトコード命令の内訳をオペコードパネルに表示します。
キーボード操作
ライブモードでは、キーボードで表示を操作します。
- q
プロファイラを終了してシェルに戻ります。
- s / S
ソート順を順方向または逆方向に切り替えます (サンプル数、割合、合計時間、累積割合、累積時間)。
- p
表示の更新を一時停止または再開します。 表示を止めてもバックグラウンドでサンプリングを続けるので、データ収集を止めずに画面を固定して結果を確認できます。
- r
すべての統計をリセットして、最初から収集し直します。 誤ってデータを失わないよう、プロファイリング終了後は無効になります。
- /
フィルターモードに入り、名前で関数を検索します。 ファイル名と関数名に対して、大文字・小文字を区別しない部分文字列の一致で絞り込みます。 パターンを入力して Enter で適用し、Escape で取り消します。 glob パターンや正規表現には対応していません。
- c
現在のフィルターを解除し、すべての関数を再表示します。
- t
全スレッドをまとめた表示と、スレッドごとの統計表示を切り替えます。 スレッドごとの表示では、
1/4のようなカウンターで、全スレッド中の現在の位置を示します。- ← → または ↑ ↓
スレッドごとの表示で、スレッド間を移動します。 最後のスレッドの次は先頭に戻り、逆方向も同様に循環します。
- + / -
表示の更新頻度を上げるか下げます。 更新間隔は 0.05 秒 (20 Hz、応答が非常に速い) から 1.0 秒 (1 Hz、オーバーヘッドが小さい) の範囲です。 更新頻度が高いほど CPU を多く使います。 デフォルトは 0.1 秒 (10 Hz) です。
- x
時間とともに各関数への処理の集中が増えているか減っているかを示す、傾向表示を切り替えます。 有効にすると、前回の更新と比較して増えた指標を緑、減った指標を赤で表示します。
- h または ?
使えるすべての操作をまとめたヘルプ画面を表示します。
- j / k (または Up / Down)
オペコードパネル内の項目を移動します (
--opcodesが有効な場合)。 現在選択している関数の命令単位の統計をスクロールします。
計測時間の終了や対象プロセスの終了によってプロファイリングが完了すると、"PROFILING COMPLETE" という表示とともに最終結果を固定します。 q で終了するまでは、移動、ソート、絞り込みを引き続き行えます。
ライブモードは、ファイルを出力する代わりに対話的な端末インターフェースを使うため、出力形式のオプション (--collapsed、--flamegraph など) とは併用できません。
非同期処理を考慮したプロファイリング
asyncio を使うプログラム向けに、プロファイラは非同期処理を考慮するモード (--async-aware) を提供しています。
生の Python フレームではなく、タスクの構造に基づいてコールスタックを再構成します。
python -m profiling.sampling run --async-aware async_script.py
非同期コードを通常の方法でプロファイルすると、物理的なコールスタックに、コルーチンの論理的な流れではなくイベントループの内部処理が現れるため、分かりにくくなることがあります。
非同期処理を考慮するモードは、実行中のタスクを追跡し、await の連鎖を反映したスタックを表示することで対処します。
import asyncio

async def fetch(url):
    await asyncio.sleep(0.1)
    return url

async def main():
    for _ in range(50):
        await asyncio.gather(fetch("a"), fetch("b"), fetch("c"))

if __name__ == "__main__":
    asyncio.run(main())
python -m profiling.sampling run --async-aware --flamegraph -o out.html script.py
注釈
非同期処理を考慮したプロファイリングには、対象プロセスで asyncio モジュールを読み込んでおく必要があります。
スクリプトが asyncio をインポートする前にプロファイルすると、このモードではタスク情報を取得できません。
非同期モード
--async-mode オプションは、プロファイルに表示するタスクを制御します。
python -m profiling.sampling run --async-aware --async-mode=running async_script.py
python -m profiling.sampling run --async-aware --async-mode=all async_script.py
--async-mode=running (デフォルト) では、現在 CPU 上で実行中のタスクだけをプロファイルします。
プログラムが実際に時間を使っている箇所を示し、性能分析では通常このモードを選びます。
--async-mode=all では、I/O、ロック、ほかのタスクを待って中断しているタスクも含めます。
プログラムが何を待っているかを理解するのに便利ですが、中断中のすべてのタスクが各サンプルに現れるため、プロファイルは大きくなります。
タスクマーカーとスタックの再構成
非同期処理を考慮したプロファイルには、asyncio タスク間の境界を示す <task> フレームが現れます。
これは、タスク構造を示すためにプロファイラが挿入する人工的なフレームです。
このフレームでは、関数名としてタスク名を表示します。
When a task awaits another task, the profiler reconstructs the logical call
chain by following the await relationships. Only "leaf" tasks (tasks that
no other task is currently awaiting) generate their own stack entries. Tasks
being awaited by other tasks appear as part of their awaiter's stack instead.
あるタスクを複数のタスクが待っている場合 (タスクのグラフがひし形になる場合)、プロファイラは一定の規則で親を一つ選び、MyTask (2 parents) のようにタスクマーカーへ親の数を付記します。
これは、別の実行経路もあるものの、このスタックには表示していないことを示します。
オプションの制約
非同期処理を考慮するモードは異なるスタック再構成機構を使うため、--native、--no-gc、--all-threads、--mode=cpu、--mode=gil とは併用できません。
コマンドライン・インターフェース
コマンドラインインターフェース全体のリファレンスです。
共通オプション
- run
Python スクリプトまたはモジュールを実行し、プロファイルします。
- attach
PID を指定して実行中のプロセスに接続し、プロファイルします。
- dump
実行中のプロセスの Python スタックのスナップショットを一回だけ表示します。
- replay
バイナリのプロファイルファイルを別の出力形式へ変換します。
dump のオプション
次のオプションは dump サブコマンドに適用されます。
- -a, --all-threads
メインスレッドだけでなく、対象プロセスのすべてのスレッドをダンプします。
- --native
Python 以外のコードについて
<native>フレームを含めます。
- --no-gc
ガベージコレクションの実行を示す
<GC>フレームを除外します。
- --opcodes
利用できる場合、バイトコードのオペコード名を表示します。
- --async-aware
asyncio アプリケーションについて、
awaitの境界をまたいでスタックを再構成します。
- --async-mode <mode>
非同期スタックのモードです。
running(実行中のタスクのみ) またはall(待機中も含むすべてのタスク) を指定します。dumpのデフォルトはallです。--async-awareが必要です。
- --blocking
スタックを読み取る間、対象プロセスのすべてのスレッドを一時停止します。
サンプリングのオプション
- -r <rate>, --sampling-rate <rate>
サンプリングレートです (
10000、10khz、10kなど)。 デフォルトは1khzです。
- -d <seconds>, --duration <seconds>
プロファイリングの計測時間を秒単位で指定します。 デフォルトでは完了まで実行します。
- -a, --all-threads
メインスレッドだけでなく、すべてのスレッドをサンプリングします。
- --realtime-stats
プロファイリング中にサンプリングの統計を表示します。
- --native
Python 以外のコードについて
<native>フレームを含めます。
- --no-gc
ガベージコレクションを示す
<GC>フレームを除外します。
- --async-aware
asyncio プログラムについて、非同期処理を考慮したプロファイリングを有効にします。
- --opcodes
Gather bytecode opcode information for instruction-level profiling. Shows which bytecode instructions are executing, including specializations. Compatible with
--live,--flamegraph,--heatmap, and--geckoformats only.
- --subprocesses
サブプロセスもプロファイルします。 サブプロセスごとにプロファイラインスタンスと出力ファイルを作成します。
--liveとは併用できません。
モードのオプション
- --mode <mode>
サンプリングモードです。
wall(デフォルト)、cpu、gil、exceptionを指定できます。cpu、gil、exceptionモードは--async-awareと併用できません。
- --async-mode <mode>
非同期プロファイリングのモードです。
running(デフォルト) またはallを指定します。--async-awareが必要です。
出力のオプション
- --collapsed
外部のフレームグラフツール向けに集約スタック形式を生成します。
- --flamegraph
単独で動作する HTML のフレームグラフを生成します。
- --diff-flamegraph <baseline.bin>
基準となるバイナリのプロファイルと比較した差分フレームグラフを生成します。
- --gecko
Firefox Profiler 用の Gecko JSON 形式を生成します。
- --heatmap
行単位のサンプル数を示す HTML ヒートマップを生成します。
- --binary
後から
replayコマンドで変換するための、高速に処理できるバイナリ形式を生成します。
- --compression <type>
バイナリ形式の圧縮方式です。
auto(zstd が使えれば使う、デフォルト)、zstd、noneを指定します。
- -o <path>, --output <path>
出力ファイルまたはディレクトリのパスです。 デフォルトの動作は形式によって異なります。
--pstatsは標準出力にテキストの表を表示し、-oを指定するとバイナリの pstats ファイルを書き込みます。 その他の形式では<format>_<PID>.<ext>という名前のファイルを生成します (例えばflamegraph_12345.html)。--heatmapはheatmap_<PID>というディレクトリを作成します。
- --browser
HTML 出力 (
--flamegraphと--heatmap) の生成後に、デフォルトの Web ブラウザーで自動的に開きます。--subprocessesでプロファイルする場合、ブラウザーを開くのはメインプロセスだけで、サブプロセスの出力を自動で開くことはありません。
pstats の表示オプション
これらのオプションは pstats 形式の出力にだけ適用されます。
- --sort <key>
ソート順です。
nsamples、tottime、cumtime、sample-pct、cumul-pct、nsamples-cumul、nameを指定できます。 デフォルトはnsamplesです。
- -l <count>, --limit <count>
表示する項目数の上限です。 デフォルトは 15 です。
- --no-summary
出力から Legend (列の説明) と Summary of Interesting Functions (注目する関数の概要) の節を省略します。
run コマンドのオプション
- -m, --module
対象をスクリプトのパスではなく、モジュール名として扱います。
- --live
バッチ処理のプロファイリングの代わりに、対話的な端末インターフェースを起動します。
参考
profilingPython のプロファイリングツールの概要と、プロファイラの選び方。
profiling.tracing正確な呼び出し回数と時間を取得する決定論的トレースプロファイラ。
pstatsプロファイルデータの統計分析。
- Firefox Profiler
Gecko 形式の出力を読み込める、Web ベースのプロファイラです。 詳しい使い方は ドキュメント を参照してください。
- FlameGraph
集約スタック形式からフレームグラフを生成するツール。