
statistics --- توابع آمار ریاضی
اضافه شده در نسخهی 3.4.
کد منبع: Lib/statistics.py
این ماژول توابعی برای محاسبهی آمار ریاضی دادههای عددی (با مقدار Real) فراهم میکند.
این ماژول بهعنوان رقیبی برای کتابخانههای شخص ثالثی مانند NumPy، SciPy، یا بستههای آماری مالکیتی و تمامامکاناتی مانند Minitab، SAS و Matlab که برای آماردانان حرفهای طراحی شدهاند، در نظر گرفته نشده است. هدف آن در سطح ماشینحسابهای نموداری و علمی است.
مگر آنکه بهصراحت ذکر شده باشد، این توابع از int، float، Decimal و Fraction پشتیبانی میکنند. رفتار آنها با انواع دیگر (چه در سلسلهمراتب عددی (numeric tower) باشند و چه نباشند) در حال حاضر پشتیبانی نمیشود. رفتار با مجموعههای دارای ترکیبی از انواع نیز تعریفنشده و وابسته به پیادهسازی است. اگر دادههای ورودی شما از انواع مختلط تشکیل شده باشد، ممکن است بتوانید برای اطمینان از نتیجهای سازگار از map() استفاده کنید، برای مثال: map(float, input_data).
برخی از مجموعهدادهها از مقادیر NaN (عدد نیست) برای نمایش دادههای مفقود استفاده میکنند. از آنجا که مقادیر NaN رفتار مقایسهای غیرمعمولی دارند، در توابع آماری که دادهها را مرتب میکنند یا رخدادها را میشمارند، باعث رفتارهای غافلگیرکننده یا تعریفنشده میشوند. توابع تحتتأثیر عبارتاند از median()، median_low()، median_high()، median_grouped()، mode()، multimode() و quantiles(). مقادیر NaN باید پیش از فراخوانی این توابع حذف شوند:
>>> from statistics import median
>>> from math import isnan
>>> from itertools import filterfalse

>>> data = [20.7, float('NaN'),19.2, 18.3, float('NaN'), 14.4]
>>> sorted(data)  # This has surprising behavior
[20.7, nan, 14.4, 18.3, 19.2, nan]
>>> median(data)  # This result is unexpected
16.35

>>> sum(map(isnan, data))    # Number of missing values
2
>>> clean = list(filterfalse(isnan, data))  # Strip NaN values
>>> clean
[20.7, 19.2, 18.3, 14.4]
>>> sorted(clean)  # Sorting now works as expected
[14.4, 18.3, 19.2, 20.7]
>>> median(clean)       # This result is now well defined
18.75
میانگینها و معیارهای مکان مرکزی
این توابع یک مقدار میانگین یا معمول را از یک جامعه یا نمونه محاسبه میکنند.
میانگین حسابی («میانگین») دادهها. |
|
میانگین حسابی ممیز شناور و سریع، با وزندهی اختیاری. |
|
میانگین هندسی دادهها. |
|
میانگین هارمونیک دادهها. |
|
توزیع چگالی احتمال دادهها را برآورد کنید. |
|
نمونهگیری تصادفی از PDF تولیدشده توسط kde(). |
|
میانه (مقدار میانی) دادهها. |
|
میانهی پایین دادهها. |
|
میانهی بالای دادهها. |
|
میانه (صدک ۵۰م) دادههای گروهبندیشده. |
|
مد تکی (رایجترین مقدار) دادههای گسسته یا اسمی. |
|
فهرست مدها (رایجترین مقادیر) دادههای گسسته یا اسمی. |
|
دادهها را به بازههایی با احتمال برابر تقسیم کنید. |
معیارهای پراکندگی
این توابع سنجهای از میزان انحراف جامعه یا نمونه از مقادیر معمول یا میانگین را محاسبه میکنند.
انحراف معیار جامعهی دادهها. |
|
واریانس جامعهی دادهها. |
|
انحراف معیار نمونه از دادهها. |
|
واریانس نمونهی دادهها. |
آمار روابط بین دو ورودی
این توابع آمار مربوط به روابط بین دو ورودی را محاسبه میکنند.
کوواریانس نمونه برای دو متغیر. |
|
ضرایب همبستگی پیرسون و اسپیرمن. |
|
شیب و عرض از مبدأ برای رگرسیون خطی ساده. |
جزئیات تابع
نکته: این توابع نیازی ندارند که دادههای دادهشده به آنها مرتبشده باشند. با این حال، برای سهولت خواندن، بیشتر مثالها دنبالههای مرتبشده را نشان میدهند.
- statistics.mean(data)
میانگین حسابی نمونهای از data را برمیگرداند، که میتواند یک دنباله یا پیمایشپذیر باشد.
میانگین حسابی، مجموع دادهها تقسیم بر تعداد نقاط داده است. این مقدار معمولاً «میانگین» نامیده میشود، هرچند تنها یکی از میانگینهای ریاضی گوناگون است. این سنجهای از موقعیت مرکزی دادهها است.
اگر data خالی باشد،
StatisticsErrorپرتاب خواهد شد.چند نمونه از کاربرد:
>>> mean([1, 2, 3, 4, 4])
2.8
>>> mean([-1.0, 2.5, 3.25, 5.75])
2.625

>>> from fractions import Fraction as F
>>> mean([F(3, 7), F(1, 21), F(5, 3), F(1, 3)])
Fraction(13, 21)

>>> from decimal import Decimal as D
>>> mean([D("0.5"), D("0.75"), D("0.625"), D("0.375")])
Decimal('0.5625')
توجه
میانگین بهشدت تحت تأثیر دادههای پرت است و لزوماً نمونهای معمولی از نقاط داده نیست. برای سنجهای مقاومتر، هرچند کمبازدهتر، از گرایش مرکزی،
median()را ببینید.میانگین نمونه، برآوردی بدون تورش از میانگین واقعی جامعه ارائه میدهد، بهطوریکه اگر روی تمام نمونههای ممکن میانگین گرفته شود،
mean(sample)به میانگین واقعی کل جامعه همگرا میشود. اگر data بهجای نمونه، کل جامعه را نشان دهد، آنگاهmean(data)معادل محاسبهی میانگین واقعی جامعه μ است.
- statistics.fmean(data, weights=None)
data را به اعداد اعشاری تبدیل کنید و میانگین حسابی را محاسبه کنید.
این سریعتر از تابع
mean()اجرا میشود و همیشه یکfloatبرمیگرداند. data میتواند دنباله یا پیمایشپذیر باشد. اگر دادههای ورودی خالی باشند، یکStatisticsErrorپرتاب میکند.>>> fmean([3.5, 4.0, 5.25]) 4.25
وزندهی اختیاری پشتیبانی میشود. برای مثال، یک استاد با اختصاص وزن ۲۰٪ به آزمونها، ۲۰٪ به تکالیف، ۳۰٪ به امتحان میانترم و ۳۰٪ به امتحان پایانترم، نمرهای برای یک درس تعیین میکند:
>>> grades = [85, 92, 83, 91]
>>> weights = [0.20, 0.20, 0.30, 0.30]
>>> fmean(grades, weights)
87.6
اگر weights ارائه شود، باید همطول با data باشد، در غیر این صورت
ValueErrorپرتاب میشود.اضافه شده در نسخهی 3.8.
تغییر یافته در نسخهی 3.11: پشتیبانی از weights افزوده شد.
- statistics.geometric_mean(data)
data را به اعداد اعشاری تبدیل کنید و میانگین هندسی را محاسبه کنید.
میانگین هندسی با استفاده از حاصلضرب مقادیر، گرایش مرکزی یا مقدار معمول دادهها را نشان میدهد (برخلاف میانگین حسابی که از مجموع آنها استفاده میکند).
در صورتی که مجموعهداده ورودی خالی باشد، شامل صفر باشد، یا شامل مقدار منفی باشد، یک
StatisticsErrorپرتاب میکند. data میتواند یک دنباله یا پیمایشپذیر باشد.تلاش خاصی برای دستیابی به نتایج دقیق انجام نمیشود. (البته ممکن است این موضوع در آینده تغییر کند.)
>>> round(geometric_mean([54, 24, 36]), 1)
36.0
اضافه شده در نسخهی 3.8.
- statistics.harmonic_mean(data, weights=None)
میانگین همساز data را برمیگرداند؛ data دنباله یا پیمایشپذیری از اعداد با مقدار حقیقی است. اگر weights حذف شده باشد یا
Noneباشد، وزندهی یکسان فرض میشود.میانگین هارمونیک، معکوس میانگین حسابی
mean()از معکوسهای دادهها است. برای مثال، میانگین هارمونیک سه مقدار a، b و c معادل3/(1/a + 1/b + 1/c)خواهد بود. اگر یکی از مقادیر صفر باشد، نتیجه صفر خواهد بود.میانگین هارمونیک نوعی میانگین است، معیاری از موقعیت مرکزی دادهها. این میانگین اغلب هنگام میانگینگیری از نسبتها یا نرخها، برای مثال سرعتها، مناسب است.
فرض کنید خودرویی ۱۰ کیلومتر را با سرعت ۴۰ کیلومتر بر ساعت، سپس ۱۰ کیلومتر دیگر را با سرعت ۶۰ کیلومتر بر ساعت طی میکند. سرعت متوسط چقدر است؟
>>> harmonic_mean([40, 60])
48.0
فرض کنید یک خودرو مسافت ۵ کیلومتر را با سرعت ۴۰ کیلومتر بر ساعت طی میکند و هنگامی که ترافیک روان میشود، برای ۳۰ کیلومتر باقیمانده از سفر، سرعت خود را به ۶۰ کیلومتر بر ساعت افزایش میدهد. سرعت متوسط چقدر است؟
>>> harmonic_mean([40, 60], weights=[5, 30])
56.0
اگر data خالی باشد، هر یک از عناصر کمتر از صفر باشد، یا مجموع وزندار مثبت نباشد، استثنای
StatisticsErrorپرتاب میشود.الگوریتم فعلی هنگامی که با یک صفر در ورودی مواجه شود، یک خروج زودهنگام (early-out) دارد. این بدان معناست که ورودیهای بعدی از نظر اعتبار بررسی نمیشوند. (این رفتار ممکن است در آینده تغییر کند.)
اضافه شده در نسخهی 3.6.
تغییر یافته در نسخهی 3.10: پشتیبانی از weights افزوده شد.
- statistics.kde(data, h, kernel='normal', *, cumulative=False)
برآورد چگالی هستهای (KDE): ایجاد یک تابع چگالی احتمال پیوسته یا تابع توزیع تجمعی از نمونههای گسسته.
ایدهی اصلی، هموارسازی دادهها با استفاده از یک تابع هسته است تا به استنتاج دربارهی یک جامعه از روی یک نمونه کمک کند.
میزان هموارسازی با پارامتر مقیاسدهی h کنترل میشود که پهنای باند نامیده میشود. مقادیر کوچکتر ویژگیهای محلی را برجسته میکنند، در حالی که مقادیر بزرگتر نتایج هموارتری میدهند.
هسته وزنهای نسبی نقاط دادههای نمونه را تعیین میکند. بهطور کلی، انتخاب شکل هسته به اندازهی پارامتر هموارسازی پهنای باند، که تأثیرگذارتر است، اهمیت ندارد.
هستههایی که به هر نقطه نمونه مقداری وزن میدهند، شامل normal (gauss)، logistic و sigmoid هستند.
هستههایی که فقط به نقاط نمونه درون پهنای باند وزن میدهند، شامل rectangular (uniform)، triangular، parabolic (epanechnikov)، quartic (biweight)، triweight و cosine هستند.
اگر cumulative درست باشد، یک تابع توزیع تجمعی برمیگرداند.
اگر دنبالهی data خالی باشد، یک
StatisticsErrorپرتاب میشود.ویکیپدیا مثالی دارد که در آن میتوانیم از
kde()برای تولید و رسم تابع چگالی احتمال برآوردشده از یک نمونه کوچک استفاده کنیم:>>> sample = [-2.1, -1.3, -0.4, 1.9, 5.1, 6.2] >>> f_hat = kde(sample, h=1.5) >>> xarr = [i/100 for i in range(-750, 1100)] >>> yarr = [f_hat(x) for x in xarr]
میتوان از نقاط
xarrوyarrبرای رسم نمودار PDF استفاده کرد: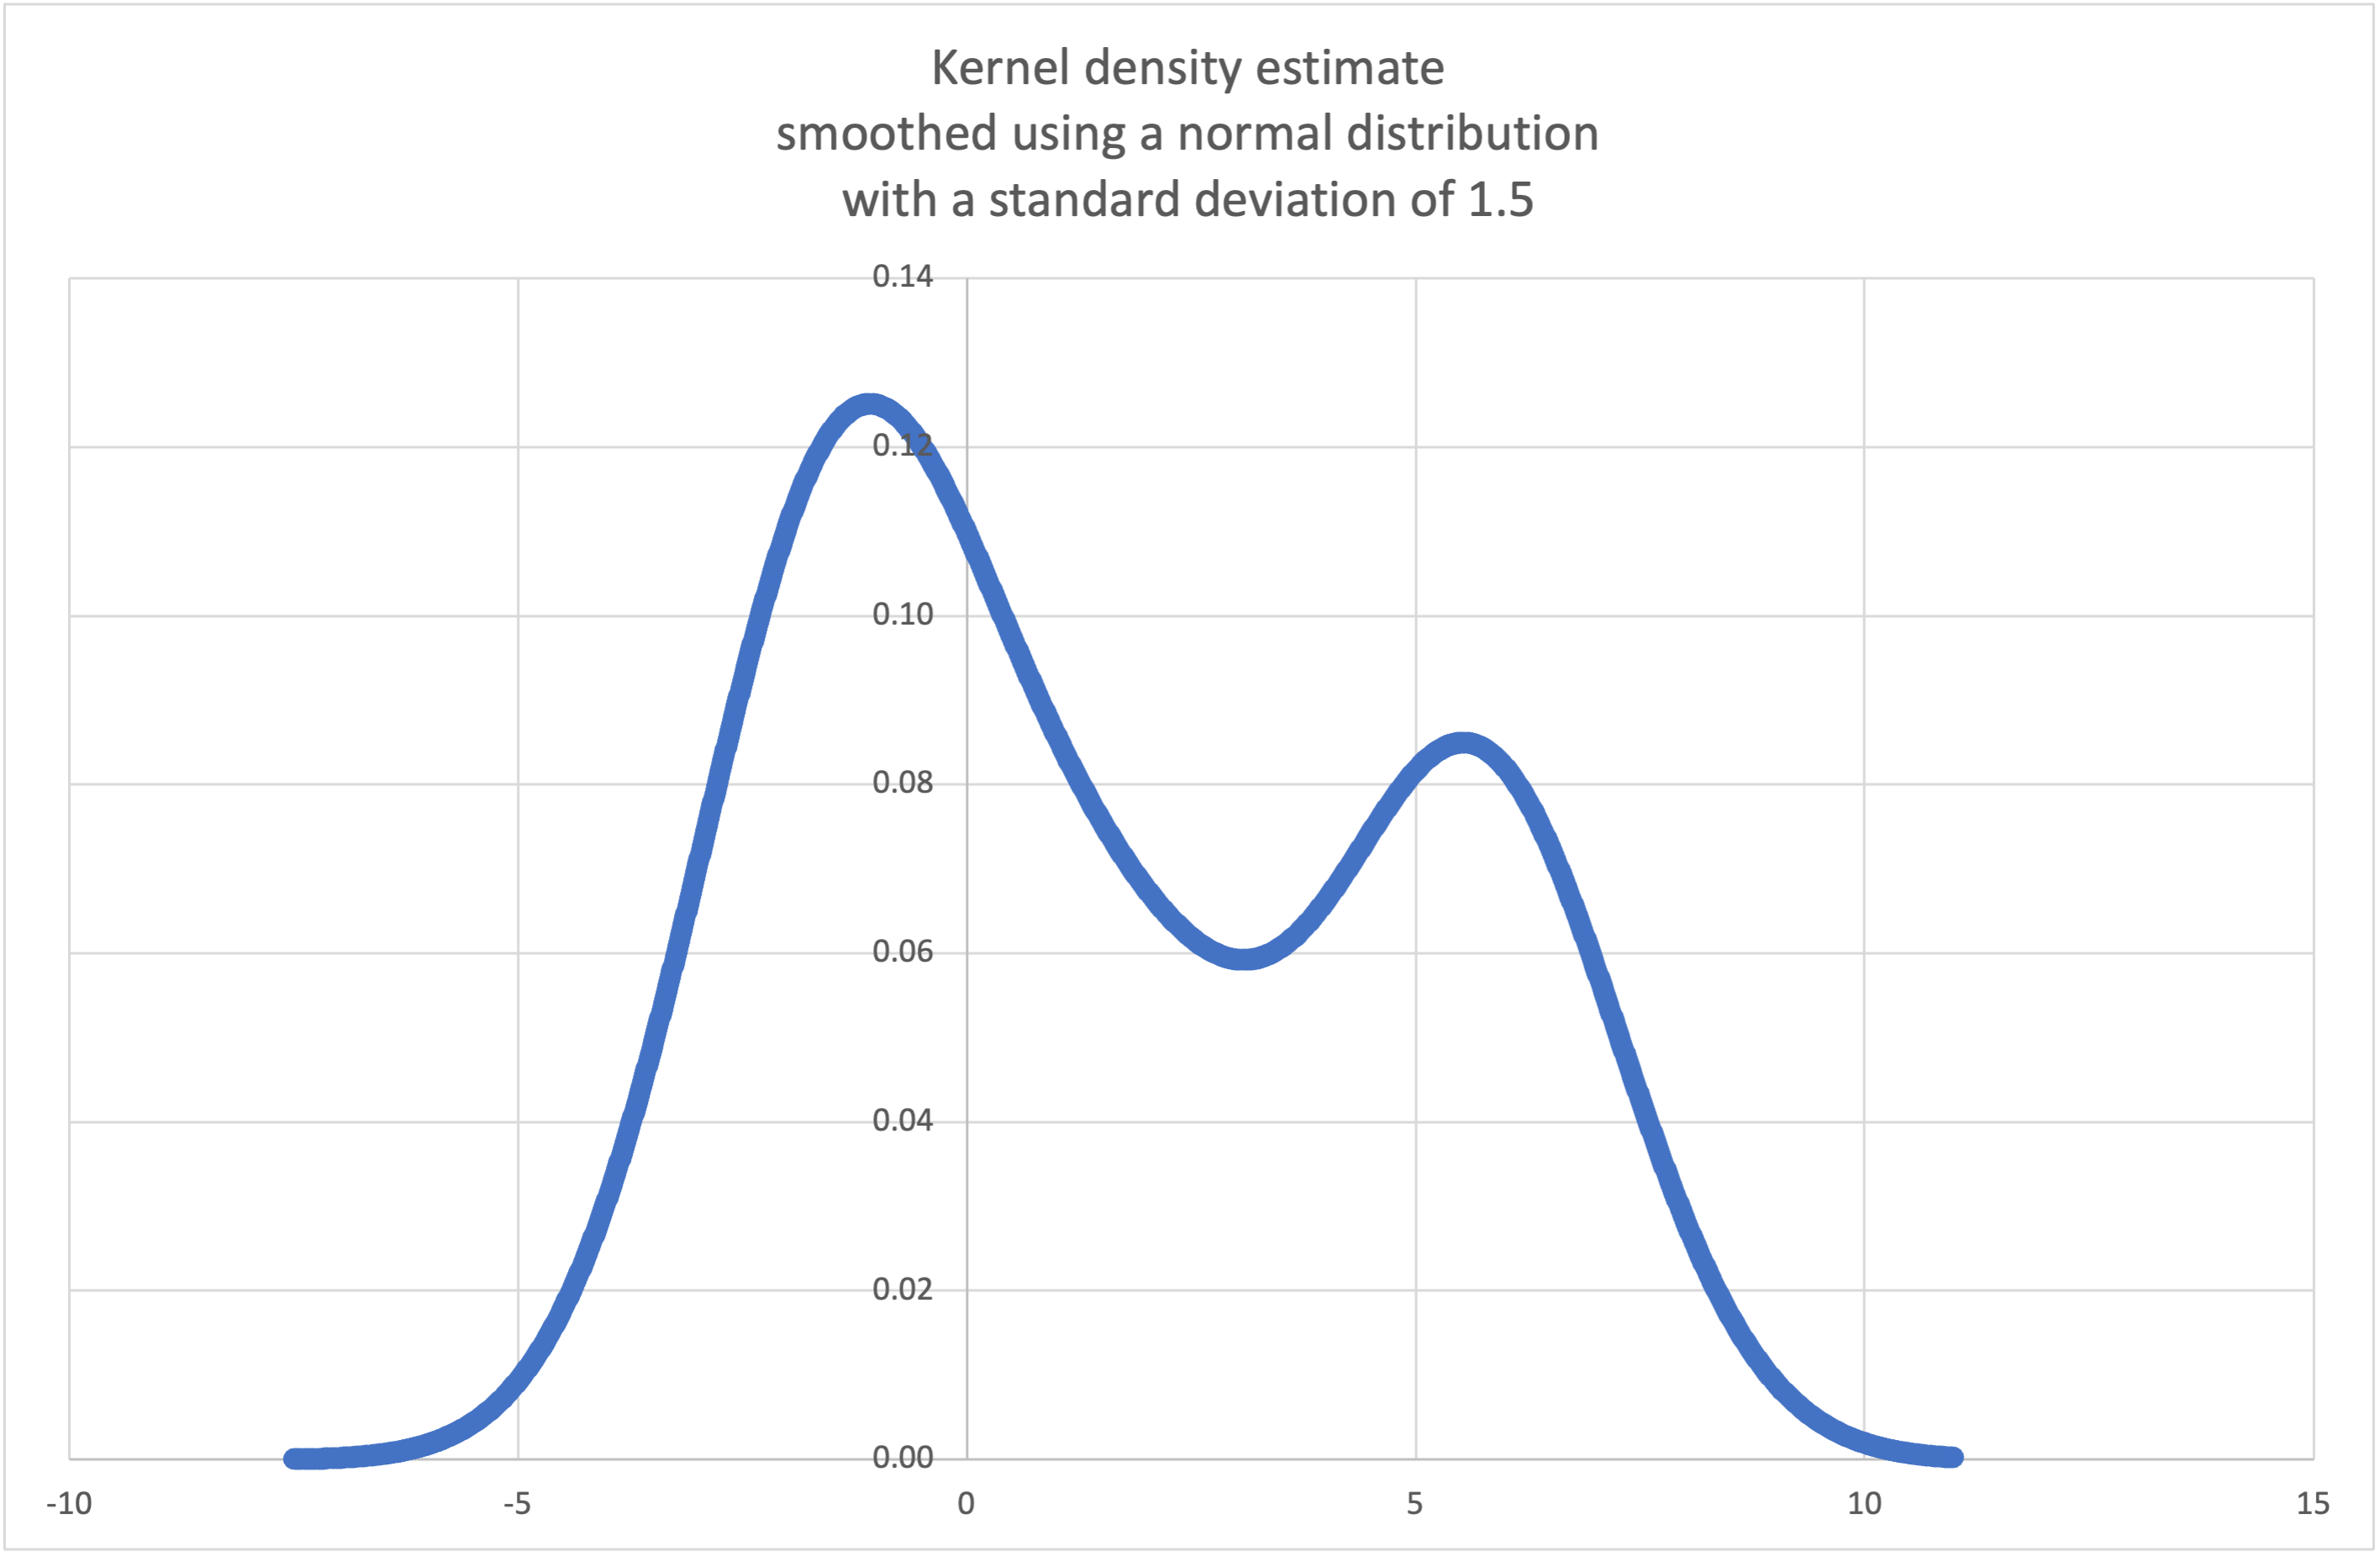
اضافه شده در نسخهی 3.13.
- statistics.kde_random(data, h, kernel='normal', *, seed=None)
تابعی را برمیگرداند که یک انتخاب تصادفی از تابع چگالی احتمال برآوردی که توسط
kde(data, h, kernel)تولید شده است، انجام میدهد.ارائه یک بذر امکان انتخابهای قابلبازتولید را فراهم میکند. در آینده، ممکن است مقادیر کمی تغییر کنند، زیرا برآردهای دقیقتر CDF معکوس هسته (kernel inverse CDF) پیادهسازی میشوند. بذر میتواند یک عدد صحیح، float، str یا bytes باشد.
اگر دنبالهی data خالی باشد، یک
StatisticsErrorپرتاب میشود.در ادامهی مثال برای
kde()، میتوانیم ازkde_random()برای تولید انتخابهای تصادفی جدید از یک تابع چگالی احتمال برآوردشده استفاده کنیم:>>> data = [-2.1, -1.3, -0.4, 1.9, 5.1, 6.2] >>> rand = kde_random(data, h=1.5, seed=8675309) >>> new_selections = [rand() for i in range(10)] >>> [round(x, 1) for x in new_selections] [0.7, 6.2, 1.2, 6.9, 7.0, 1.8, 2.5, -0.5, -1.8, 5.6]
اضافه شده در نسخهی 3.13.
- statistics.median(data)
میانه (مقدار میانی) دادههای عددی را با استفاده از روش رایج «میانگین دو مقدار میانی» برمیگرداند. اگر data خالی باشد،
StatisticsErrorپرتاب میشود. data میتواند یک دنباله یا پیمایشپذیر باشد.میانه یک معیار مقاوم برای موقعیت مرکزی است و کمتر تحت تأثیر وجود دادههای پرت قرار میگیرد. هنگامی که تعداد نقاط داده فرد باشد، نقطه داده میانی برگردانده میشود:
>>> median([1, 3, 5])
3
هنگامی که تعداد نقاط داده زوج باشد، میانه با گرفتن میانگین دو مقدار میانی درونیابی میشود:
>>> median([1, 3, 5, 7])
4.0
این برای زمانی مناسب است که دادههای شما گسسته باشند و برای شما مهم نباشد که میانه ممکن است یک نقطه داده واقعی نباشد.
اگر دادهها ترتیبی باشند (از عملیات ترتیب پشتیبانی میکنند) اما عددی نباشند (از جمع پشتیبانی نمیکنند)، در عوض استفاده از
median_low()یاmedian_high()را در نظر بگیرید.
- statistics.median_low(data)
میانهی پایین دادههای عددی را برمیگرداند. اگر data خالی باشد،
StatisticsErrorپرتاب میشود. data میتواند یک دنباله یا پیمایشپذیر باشد.میانهی پایین همیشه عضوی از مجموعهی داده است. هرگاه تعداد نقاط داده فرد باشد، مقدار میانی برگردانده میشود. هرگاه زوج باشد، کوچکتر از میان دو مقدار میانی برگردانده میشود.
>>> median_low([1, 3, 5])
3
>>> median_low([1, 3, 5, 7])
3
زمانی که دادههای شما گسسته هستند و ترجیح میدهید میانه یک نقطه داده واقعی باشد، نه درونیابیشده، از میانه پایین استفاده کنید.
- statistics.median_high(data)
میانه بالایی داده را برمیگرداند. اگر data خالی باشد،
StatisticsErrorپرتاب میشود. data میتواند یک دنباله یا پیمایشپذیر باشد.میانهی بالا همواره عضوی از مجموعهی داده است. هنگامی که تعداد نقاط داده فرد باشد، مقدار میانی بازگردانده میشود. هنگامی که زوج باشد، بزرگتر از میان دو مقدار میانی بازگردانده میشود.
>>> median_high([1, 3, 5])
3
>>> median_high([1, 3, 5, 7])
5
از میانهی بالا زمانی استفاده کنید که دادههای شما گسسته هستند و ترجیح میدهید میانه یک نقطه داده واقعی باشد، نه درونیابیشده.
- statistics.median_grouped(data, interval=1.0)
میانه را برای دادههای عددی که حول نقاط میانی بازههای متوالی با عرض ثابت گروهبندی یا سطلبندی (binning) شدهاند، برآورد میکند.
data میتواند هر پیمایشپذیری از دادههای عددی باشد، بهطوریکه هر مقدار دقیقاً نقطهی میانی یک بازه (bin) باشد. حداقل باید یک مقدار وجود داشته باشد.
interval عرض هر سطل است.
برای مثال، ممکن است اطلاعات جمعیتشناختی به گروههای سنی ۱۰ سالهی متوالی خلاصه شده باشد که هر گروه با نقاط میانی ۵ سالهی بازهها نمایش داده میشود:
>>> from collections import Counter
>>> demographics = Counter({
...    25: 172,   # 20 to 30 years old
...    35: 484,   # 30 to 40 years old
...    45: 387,   # 40 to 50 years old
...    55:  22,   # 50 to 60 years old
...    65:   6,   # 60 to 70 years old
... })
...
صدک پنجاهم (میانه) ۵۳۶امین نفر از گروه ۱۰۷۱ نفری اعضا است. آن فرد در گروه سنی ۳۰ تا ۴۰ سال قرار دارد.
تابع معمولی
median()فرض میکند که همهی اعضای گروه سنی دههی سی دقیقاً ۳۵ سال دارند. فرض معقولتر این است که ۴۸۴ عضو آن گروه سنی بهطور یکنواخت بین ۳۰ و ۴۰ سال توزیع شدهاند. برای این منظور، ازmedian_grouped()استفاده میکنیم:>>> data = list(demographics.elements()) >>> median(data) 35 >>> round(median_grouped(data, interval=10), 1) 37.5
فراخواننده مسئول اطمینان از این است که نقاط داده با مضارب دقیقی از interval از هم جدا شده باشند. این امر برای به دست آوردن نتیجهی صحیح ضروری است. تابع این پیششرایط را بررسی نمیکند.
ورودیها میتوانند از هر نوع عددی باشند که بتوان آن را در مرحلهی درونیابی به float تبدیل کرد.
- statistics.mode(data)
رایجترین دادهی منفرد را از دادههای گسسته یا اسمی برمیگرداند. مد (در صورت وجود) معمولترین مقدار است و بهعنوان معیاری برای مکان مرکزی به کار میرود.
اگر چندین مد با فراوانی یکسان وجود داشته باشد، اولین مورد مشاهدهشده در data را برمیگرداند. اگر بهجای آن، کوچکترین یا بزرگترین آنها مطلوب باشد، از
min(multimode(data))یاmax(multimode(data))استفاده کنید. اگر data ورودی خالی باشد،StatisticsErrorپرتاب میشود.modeفرض میکند که دادهها گسستهاند و یک مقدار واحد را بازمیگرداند. این روش استاندارد برای مُد است که معمولاً در مدارس آموزش داده میشود:>>> mode([1, 1, 2, 3, 3, 3, 3, 4]) 3
مُد از این جهت منحصربهفرد است که تنها آمارهی این بسته است که بر دادههای اسمی (غیرعددی) نیز اعمال میشود:
>>> mode(["red", "blue", "blue", "red", "green", "red", "red"])
'red'
فقط ورودیهای هشپذیر پشتیبانی میشوند. برای مدیریت نوع
set، تبدیل آن بهfrozensetرا در نظر بگیرید. برای مدیریت نوعlist، تبدیل آن بهtupleرا در نظر بگیرید. برای ورودیهای ترکیبی یا تودرتو، استفاده از این الگوریتم درجهدوی کندتر را در نظر بگیرید که فقط به آزمونهای برابری وابسته است:max(data, key=data.count).تغییر یافته در نسخهی 3.8: اکنون مجموعهدادههای چندمدی را با برگرداندن نخستین مد مشاهدهشده مدیریت میکند. پیشتر، هنگامی که بیش از یک مد یافت میشد،
StatisticsErrorرا پرتاب میکرد.
- statistics.multimode(data)
فهرستی از پرتکرارترین مقادیر را به ترتیبی که برای اولین بار در data دیده شدهاند برمیگرداند. اگر چند مد وجود داشته باشد، بیش از یک نتیجه و اگر data خالی باشد، یک فهرست خالی برمیگرداند:
>>> multimode('aabbbbccddddeeffffgg')
['b', 'd', 'f']
>>> multimode('')
[]
اضافه شده در نسخهی 3.8.
- statistics.pstdev(data, mu=None)
انحراف معیار جامعه را برمیگرداند (ریشه دوم واریانس جامعه). برای آرگومانها و سایر جزئیات،
pvariance()را ببینید.>>> pstdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 0.986893273527251
- statistics.pvariance(data, mu=None)
واریانس جامعهی data، یک دنباله یا پیمایشپذیر غیرخالی از اعداد با مقدار حقیقی، را برمیگرداند. واریانس، یا گشتاور دوم حول میانگین، معیاری از تغییرپذیری (گستردگی یا پراکندگی) دادهها است. واریانس بزرگ نشان میدهد که دادهها پراکندهاند؛ واریانس کوچک نشان میدهد که دادهها بهصورت فشردهای حول میانگین جمع شدهاند.
اگر آرگومان اختیاری دوم mu داده شود، باید میانگین جامعه برای data باشد. همچنین میتوان از آن برای محاسبهی گشتاور دوم حول نقطهای که میانگین نیست استفاده کرد. اگر این آرگومان موجود نباشد یا
None(پیشفرض) باشد، میانگین حسابی بهطور خودکار محاسبه میشود.برای محاسبهی واریانس کل جامعه، از این تابع استفاده کنید. برای برآورد واریانس از یک نمونه، معمولاً تابع
variance()انتخاب بهتری است.اگر data خالی باشد،
StatisticsErrorپرتاب میشود.مثالها:
>>> data = [0.0, 0.25, 0.25, 1.25, 1.5, 1.75, 2.75, 3.25]
>>> pvariance(data)
1.25
اگر میانگین دادههای خود را از پیش محاسبه کردهاید، میتوانید آن را بهعنوان آرگومان اختیاری دوم mu ارسال کنید تا از محاسبه مجدد جلوگیری شود:
>>> mu = mean(data)
>>> pvariance(data, mu)
1.25
از دسیمالها و کسرها پشتیبانی میشود:
>>> from decimal import Decimal as D
>>> pvariance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('24.815')

>>> from fractions import Fraction as F
>>> pvariance([F(1, 4), F(5, 4), F(1, 2)])
Fraction(13, 72)
توجه
هنگامی که با کل جامعه فراخوانی شود، واریانس جامعه σ² را میدهد. هنگامی که بهجای آن روی یک نمونه فراخوانی شود، این واریانس نمونهای سوگیردار s² است، که بهعنوان واریانس با N درجه آزادی نیز شناخته میشود.
اگر بهنحوی میانگین واقعی جامعه μ را میدانید، میتوانید از این تابع برای محاسبه واریانس یک نمونه استفاده کنید و میانگین معلوم جامعه را بهعنوان آرگومان دوم بدهید. مشروط بر اینکه نقاط داده نمونهای تصادفی از جامعه باشند، نتیجه برآوردی بدون تورش از واریانس جامعه خواهد بود.
- statistics.stdev(data, xbar=None)
بازگرداندن انحراف معیار نمونه (جذر واریانس نمونه). برای آرگومانها و سایر جزئیات،
variance()را ببینید.>>> stdev([1.5, 2.5, 2.5, 2.75, 3.25, 4.75]) 1.0810874155219827
- statistics.variance(data, xbar=None)
واریانس نمونهی data، پیمایشپذیری از حداقل دو عدد با مقدار حقیقی، را برمیگرداند. واریانس، یا گشتاور دوم حول میانگین، معیاری برای تغییرپذیری (گستردگی یا پراکندگی) دادهها است. واریانس بزرگ نشان میدهد که دادهها پراکندهاند؛ واریانس کوچک نشان میدهد که دادهها بهطور فشردهای حول میانگین متمرکز شدهاند.
اگر آرگومان اختیاری دوم xbar داده شود، باید میانگین نمونه از data باشد. اگر این آرگومان داده نشود یا
Noneباشد (پیشفرض)، میانگین بهطور خودکار محاسبه میشود.هرگاه دادههای شما نمونهای از یک جامعه باشند، از این تابع استفاده کنید. برای محاسبه واریانس کل جامعه،
pvariance()را ببینید.اگر data کمتر از ۲ مقدار داشته باشد،
StatisticsErrorپرتاب میشود.مثالها:
>>> data = [2.75, 1.75, 1.25, 0.25, 0.5, 1.25, 3.5]
>>> variance(data)
1.3720238095238095
اگر میانگین نمونه دادههای خود را از قبل محاسبه کردهاید، میتوانید آن را بهعنوان آرگومان دوم اختیاری xbar ارسال کنید تا از محاسبه مجدد جلوگیری شود:
>>> m = mean(data)
>>> variance(data, m)
1.3720238095238095
این تابع برای تأیید اینکه شما میانگین واقعی را بهعنوان xbar ارسال کردهاید، تلاشی نمیکند. استفاده از مقادیر دلخواه برای xbar میتواند به نتایج نامعتبر یا غیرممکن منجر شود.
مقادیر Decimal و Fraction پشتیبانی میشوند:
>>> from decimal import Decimal as D
>>> variance([D("27.5"), D("30.25"), D("30.25"), D("34.5"), D("41.75")])
Decimal('31.01875')

>>> from fractions import Fraction as F
>>> variance([F(1, 6), F(1, 2), F(5, 3)])
Fraction(67, 108)
توجه
این واریانس نمونهی s² با تصحیح بسل است که بهعنوان واریانس با N-1 درجه آزادی نیز شناخته میشود. مشروط بر اینکه نقاط داده معرف باشند (مثلاً مستقل و همتوزیع)، نتیجه باید یک برآورد بدون تورش از واریانس واقعی جامعه باشد.
اگر بهنحوی میانگین واقعی جامعه μ را میدانید، باید آن را بهعنوان پارامتر mu به تابع
pvariance()بدهید تا واریانس یک نمونه به دست آید.
- statistics.quantiles(data, *, n=4, method='exclusive')
data را به n بازهی پیوسته با احتمال برابر تقسیم میکند. فهرستی از
n - 1نقطهی اسلایس برمیگرداند که بازهها را از هم جدا میکنند.n را برای چارکها روی ۴ تنظیم کنید (پیشفرض). n را برای دهکها روی ۱۰ تنظیم کنید. n را برای صدکها روی ۱۰۰ تنظیم کنید تا ۹۹ نقطه اسلایس به دست بیاید که data را به ۱۰۰ گروه هماندازه تقسیم میکنند. اگر n حداقل ۱ نباشد،
StatisticsErrorپرتاب میشود.data میتواند هر پیمایشپذیری شامل دادههای نمونه باشد. برای نتایج معنادار، تعداد نقاط داده در data باید از n بیشتر باشد. اگر حداقل یک نقطه داده وجود نداشته باشد،
StatisticsErrorپرتاب میشود.نقاط اسلایس (cut points) بهصورت خطی از دو نقطه داده نزدیک درونیابی میشوند. برای مثال، اگر یک نقطه اسلایس در یکسوم فاصله بین دو مقدار نمونه
100و112قرار بگیرد، نقطه اسلایس به مقدار104ارزیابی میشود.متد محاسبهی چندکها میتواند بسته به اینکه داده کمترین و بیشترین مقادیر ممکن از جامعه را شامل شود یا آنها را خارج کند، متفاوت باشد.
متد پیشفرض "exclusive" است و برای دادههای نمونهگیریشده از یک جامعه آماری استفاده میشود که میتواند مقادیری حدیتر از آنچه در نمونهها یافت میشود، داشته باشد. نسبت بخشی از جامعه آماری که پایینتر از i-امین نقطه از m نقطه داده مرتبشده قرار میگیرد، بهصورت
i / (m + 1)محاسبه میشود. با داشتن نه مقدار نمونه، این متد آنها را مرتب میکند و صدکهای زیر را اختصاص میدهد: ۱۰٪، ۲۰٪، ۳۰٪، ۴۰٪، ۵۰٪، ۶۰٪، ۷۰٪، ۸۰٪، ۹۰٪.تنظیم method روی "inclusive" برای توصیف دادههای جامعه یا برای نمونههایی استفاده میشود که معلوم است شامل افراطیترین مقادیر جامعه هستند. کمترین مقدار در data بهعنوان صفرمین صدک و بیشترین مقدار بهعنوان صدمین صدک در نظر گرفته میشود. نسبتی از جامعه که پایینتر از i-امین نقطه از m نقطه داده مرتبشده قرار دارد، بهصورت
(i - 1) / (m - 1)محاسبه میشود. با داشتن ۱۱ مقدار نمونه، این متد آنها را مرتب میکند و صدکهای زیر را اختصاص میدهد: ۰٪، ۱۰٪، ۲۰٪، ۳۰٪، ۴۰٪، ۵۰٪، ۶۰٪، ۷۰٪، ۸۰٪، ۹۰٪، ۱۰۰٪.# Decile cut points for empirically sampled data >>> data = [105, 129, 87, 86, 111, 111, 89, 81, 108, 92, 110, ... 100, 75, 105, 103, 109, 76, 119, 99, 91, 103, 129, ... 106, 101, 84, 111, 74, 87, 86, 103, 103, 106, 86, ... 111, 75, 87, 102, 121, 111, 88, 89, 101, 106, 95, ... 103, 107, 101, 81, 109, 104] >>> [round(q, 1) for q in quantiles(data, n=10)] [81.0, 86.2, 89.0, 99.4, 102.5, 103.6, 106.0, 109.8, 111.0]
اضافه شده در نسخهی 3.8.
تغییر یافته در نسخهی 3.13: دیگر برای ورودیای با تنها یک نقطه داده، استثنایی پرتاب نمیکند. این امکان را فراهم میکند که برآوردهای چندک (quantile) هر بار با یک نقطه نمونه ساخته شوند و با هر نقطه داده جدید بهتدریج دقیقتر شوند.
- statistics.covariance(x, y, /)
کوواریانس نمونه دو ورودی x و y را برمیگرداند. کوواریانس معیاری از تغییرپذیری مشترک دو ورودی است.
هر دو ورودی باید طول یکسانی داشته باشند (طولشان کمتر از ۲ نباشد)، در غیر این صورت
StatisticsErrorپرتاب میشود.مثالها:
>>> x = [1, 2, 3, 4, 5, 6, 7, 8, 9]
>>> y = [1, 2, 3, 1, 2, 3, 1, 2, 3]
>>> covariance(x, y)
0.75
>>> z = [9, 8, 7, 6, 5, 4, 3, 2, 1]
>>> covariance(x, z)
-7.5
>>> covariance(z, x)
-7.5
اضافه شده در نسخهی 3.10.
- statistics.correlation(x, y, /, *, method='linear')
ضریب همبستگی پیرسون را برای دو ورودی برمیگرداند. ضریب همبستگی پیرسون r مقادیری بین -۱ و +۱ میگیرد. این ضریب، شدت و جهت یک رابطه خطی را اندازهگیری میکند.
اگر method برابر با "ranked" باشد، ضریب همبستگی رتبهای اسپیرمن را برای دو ورودی محاسبه میکند. دادهها با رتبهها جایگزین میشوند. برای مقادیر برابر، میانگین رتبهها گرفته میشود تا مقادیر مساوی رتبه یکسانی دریافت کنند. ضریب حاصل، شدت رابطهی یکنواخت را میسنجد.
ضریب همبستگی اسپیرمن برای دادههای رتبهای یا دادههای پیوستهای که شرط تناسب خطی برای ضریب همبستگی پیرسون را برآورده نمیکنند، مناسب است.
هر دو ورودی باید همطول باشند (طولشان کمتر از ۲ نباشد) و نباید ثابت باشند؛ در غیر این صورت
StatisticsErrorپرتاب میشود.مثالی با قوانین کپلر در حرکت سیارات:
>>> # Mercury, Venus, Earth, Mars, Jupiter, Saturn, Uranus, and  Neptune
>>> orbital_period = [88, 225, 365, 687, 4331, 10_756, 30_687, 60_190]    # days
>>> dist_from_sun = [58, 108, 150, 228, 778, 1_400, 2_900, 4_500] # million km

>>> # Show that a perfect monotonic relationship exists
>>> correlation(orbital_period, dist_from_sun, method='ranked')
1.0

>>> # Observe that a linear relationship is imperfect
>>> round(correlation(orbital_period, dist_from_sun), 4)
0.9882

>>> # Demonstrate Kepler's third law: There is a linear correlation
>>> # between the square of the orbital period and the cube of the
>>> # distance from the sun.
>>> period_squared = [p * p for p in orbital_period]
>>> dist_cubed = [d * d * d for d in dist_from_sun]
>>> round(correlation(period_squared, dist_cubed), 4)
1.0
اضافه شده در نسخهی 3.10.
تغییر یافته در نسخهی 3.12: پشتیبانی از ضریب همبستگی رتبهای اسپیرمن افزوده شد.
- statistics.linear_regression(x, y, /, *, proportional=False)
شیب و عرض از مبدأ پارامترهای رگرسیون خطی ساده برآوردشده با روش کمترین مربعات معمولی را برمیگرداند. رگرسیون خطی ساده رابطه بین یک متغیر مستقل x و یک متغیر وابسته y را در قالب این تابع خطی توصیف میکند:
y = slope * x + intercept + noise
که در آن
slopeوinterceptپارامترهای رگرسیون هستند که برآورد میشوند، وnoiseتغییرپذیری دادهها را که توسط رگرسیون خطی تبیین نشده است نشان میدهد (این مقدار برابر با تفاوت بین مقادیر پیشبینیشده و واقعی متغیر وابسته است).هر دو ورودی باید طول یکسانی داشته باشند (حداقل ۲)، و متغیر مستقل x نمیتواند ثابت باشد؛ در غیر این صورت
StatisticsErrorپرتاب میشود.برای مثال، میتوانیم از تاریخهای انتشار فیلمهای مانتی پایتون برای پیشبینی تعداد تجمعی فیلمهای مانتی پایتون که با فرض حفظ آهنگ تولید، تا سال ۲۰۱۹ تولید شده بودند، استفاده کنیم.
>>> year = [1971, 1975, 1979, 1982, 1983]
>>> films_total = [1, 2, 3, 4, 5]
>>> slope, intercept = linear_regression(year, films_total)
>>> round(slope * 2019 + intercept)
16
اگر proportional درست باشد، فرض میشود که متغیر مستقل x و متغیر وابسته y با یکدیگر نسبت مستقیم دارند. دادهها به خطی که از مبدأ میگذرد برازش داده میشوند. از آنجا که intercept همواره برابر 0.0 خواهد بود، تابع خطی زیربنایی بهصورت زیر ساده میشود:
y = slope * x + noise
در ادامهی مثال
correlation()، بررسی میکنیم که مدلی مبتنی بر سیارههای بزرگ تا چه اندازه میتواند فاصلههای مداری سیارههای کوتوله را پیشبینی کند:>>> model = linear_regression(period_squared, dist_cubed, proportional=True) >>> slope = model.slope >>> # Dwarf planets: Pluto, Eris, Makemake, Haumea, Ceres >>> orbital_periods = [90_560, 204_199, 111_845, 103_410, 1_680] # days >>> predicted_dist = [math.cbrt(slope * (p * p)) for p in orbital_periods] >>> list(map(round, predicted_dist)) [5912, 10166, 6806, 6459, 414] >>> [5_906, 10_152, 6_796, 6_450, 414] # actual distance in million km [5906, 10152, 6796, 6450, 414]
اضافه شده در نسخهی 3.10.
تغییر یافته در نسخهی 3.11: پشتیبانی از proportional افزوده شد.
استثناها
تنها یک استثنا تعریف شده است:
- exception statistics.StatisticsError
زیرکلاسی از
ValueErrorبرای استثناهای مرتبط با آمار.
اشیای NormalDist
NormalDist ابزاری برای ایجاد و دستکاری توزیعهای نرمال یک متغیر تصادفی است. این یک کلاس است که میانگین و انحراف معیار اندازهگیریهای داده را بهعنوان یک موجودیت واحد در نظر میگیرد.
توزیعهای نرمال از قضیه حد مرکزی ناشی میشوند و کاربردهای گستردهای در آمار دارند.
- class statistics.NormalDist(mu=0.0, sigma=1.0)
یک شیء NormalDist جدید برمیگرداند که در آن mu نشاندهندهی میانگین حسابی و sigma نشاندهندهی انحراف معیار است.
اگر sigma منفی باشد،
StatisticsErrorپرتاب میشود.- mean
یک ویژگی فقطخواندنی برای میانگین حسابی یک توزیع نرمال.
- stdev
ویژگی فقطخواندنی برای انحراف معیار توزیع نرمال.
- classmethod from_samples(data)
یک نمونه توزیع نرمال میسازد که پارامترهای mu و sigma آن از data با استفاده از
fmean()وstdev()برآورد شدهاند.data میتواند هر پیمایشپذیر باشد و باید شامل مقادیری باشد که بتوان آنها را به نوع
floatتبدیل کرد. اگر data شامل حداقل دو عنصر نباشد،StatisticsErrorپرتاب میشود؛ زیرا برای برآورد مقدار مرکزی حداقل به یک نقطه و برای برآورد پراکندگی حداقل به دو نقطه نیاز است.
- samples(n, *, seed=None)
n نمونه تصادفی برای میانگین و انحراف معیار دادهشده تولید میکند. یک
listاز مقادیرfloatرا برمیگرداند.اگر seed داده شود، نمونهای جدید از تولیدگر اعداد تصادفی زیربنایی ایجاد میشود. این برای ایجاد نتایج قابل بازتولید، حتی در یک زمینهی چندنخی، مفید است.
تغییر یافته در نسخهی 3.13.
به یک الگوریتم سریعتر تغییر یافت. برای تولید مجدد نمونهها از نسخههای پیشین، از
random.seed()وrandom.gauss()استفاده کنید.
- pdf(x)
با استفاده از تابع چگالی احتمال (pdf)، احتمال نسبی اینکه یک متغیر تصادفی X در نزدیکی مقدار دادهشده x باشد را محاسبه کنید. از نظر ریاضی، این حد نسبت
P(x <= X < x+dx) / dxاست، وقتی که dx به صفر میل میکند.درستنمایی نسبی بهصورت احتمال وقوع یک نمونه در یک بازهی باریک تقسیم بر پهنای آن بازه محاسبه میشود (از این رو واژهی «چگالی»). از آنجا که درستنمایی نسبت به سایر نقاط نسبی است، مقدار آن میتواند بزرگتر از
1.0باشد.
- cdf(x)
با استفاده از تابع توزیع تجمعی (cdf)، احتمال اینکه متغیر تصادفی X کوچکتر یا مساوی x باشد را محاسبه کنید. از نظر ریاضی، بهصورت
P(X <= x)نوشته میشود.
- inv_cdf(p)
محاسبهی تابع توزیع تجمعی معکوس، که بهعنوان تابع چارک یا تابع نقطهدرصدی نیز شناخته میشود. از نظر ریاضی، بهصورت
x : P(X <= x) = pنوشته میشود.مقدار x از متغیر تصادفی X را مییابد، بهطوری که احتمال اینکه متغیر کوچکتر یا مساوی آن مقدار باشد، برابر با احتمال دادهشده p است.
- overlap(other)
میزان انطباق بین دو توزیع احتمال نرمال را اندازهگیری میکند. مقداری بین ۰٫۰ و ۱٫۰ برمیگرداند که مساحت همپوشانی دو تابع چگالی احتمال را نشان میدهد.
- quantiles(n=4)
توزیع نرمال را به n بازهی پیوسته با احتمال برابر تقسیم میکند. فهرستی از (n - 1) نقطهی اسلایس را برمیگرداند که بازهها را از هم جدا میکنند.
n را برای چارکها روی ۴ تنظیم کنید (پیشفرض). n را برای دهکها روی ۱۰ تنظیم کنید. n را برای صدکها روی ۱۰۰ تنظیم کنید تا ۹۹ نقطه اسلایس به دست آید که توزیع نرمال را به ۱۰۰ گروه هماندازه تقسیم میکنند.
- zscore(x)
نمره استاندارد را که x را بر حسب تعداد انحرافهای معیار بالاتر یا پایینتر از میانگین توزیع نرمال توصیف میکند، محاسبه کنید:
(x - mean) / stdev.اضافه شده در نسخهی 3.9.
نمونههای
NormalDistاز جمع، تفریق، ضرب و تقسیم بر یک ثابت پشتیبانی میکنند. این عملیات برای انتقال و مقیاسدهی استفاده میشوند. برای مثال:>>> temperature_february = NormalDist(5, 2.5) # Celsius >>> temperature_february * (9/5) + 32 # Fahrenheit NormalDist(mu=41.0, sigma=4.5)
تقسیم یک ثابت بر نمونهای از
NormalDistپشتیبانی نمیشود، زیرا نتیجه توزیع نرمال نخواهد داشت.از آنجا که توزیعهای نرمال از اثرات افزایشی متغیرهای مستقل ناشی میشوند، میتوان جمع و تفریق دو متغیر تصادفی مستقل با توزیع نرمال را که بهصورت نمونههایی از
NormalDistنمایش داده شدهاند، انجام داد. برای مثال:>>> birth_weights = NormalDist.from_samples([2.5, 3.1, 2.1, 2.4, 2.7, 3.5]) >>> drug_effects = NormalDist(0.4, 0.15) >>> combined = birth_weights + drug_effects >>> round(combined.mean, 1) 3.1 >>> round(combined.stdev, 1) 0.5
اضافه شده در نسخهی 3.8.
مثالها و دستور پختها
مسائل کلاسیک احتمال
NormalDist بهسادگی مسائل کلاسیک احتمال را حل میکند.
برای مثال، با توجه به دادههای تاریخی آزمونهای SAT که نشان میدهد نمرات بهطور نرمال با میانگین ۱۰۶۰ و انحراف معیار ۱۹۵ توزیع شدهاند، درصد دانشآموزانی را که نمرهی آزمون آنها بین ۱۱۰۰ و ۱۲۰۰ است، پس از گرد کردن به نزدیکترین عدد حسابی تعیین کنید:
>>> sat = NormalDist(1060, 195)
>>> fraction = sat.cdf(1200 + 0.5) - sat.cdf(1100 - 0.5)
>>> round(fraction * 100.0, 1)
18.4
چارکها و دهکها را برای نمرات SAT بیابید:
>>> list(map(round, sat.quantiles()))
[928, 1060, 1192]
>>> list(map(round, sat.quantiles(n=10)))
[810, 896, 958, 1011, 1060, 1109, 1162, 1224, 1310]
ورودیهای مونتکارلو برای شبیهسازیها
برای برآورد توزیع مدلی که حل آن بهصورت تحلیلی آسان نیست، NormalDist میتواند نمونههای ورودی برای یک شبیهسازی مونتکارلو تولید کند:
>>> def model(x, y, z):
...     return (3*x + 7*x*y - 5*y) / (11 * z)
...
>>> n = 100_000
>>> X = NormalDist(10, 2.5).samples(n, seed=3652260728)
>>> Y = NormalDist(15, 1.75).samples(n, seed=4582495471)
>>> Z = NormalDist(50, 1.25).samples(n, seed=6582483453)
>>> quantiles(map(model, X, Y, Z))
[1.4591308524824727, 1.8035946855390597, 2.175091447274739]
تقریب توزیعهای دوجملهای
وقتی اندازه نمونه بزرگ باشد و احتمال موفقیت یک آزمایش نزدیک به ۵۰٪ باشد، میتوان از توزیعهای نرمال برای تقریب توزیعهای دوجملهای استفاده کرد.
برای مثال، یک همایش متنباز ۷۵۰ شرکتکننده و دو اتاق با ظرفیت ۵۰۰ نفری دارد. یک سخنرانی درباره پایتون و یک سخنرانی دیگر درباره روبی وجود دارد. در همایشهای قبلی، ۶۵٪ شرکتکنندگان ترجیح میدادند به سخنرانیهای پایتون گوش دهند. با فرض اینکه ترجیحات جامعه تغییر نکرده باشد، احتمال اینکه اتاق پایتون در محدوده ظرفیت خود باقی بماند، چقدر است؟
>>> n = 750             # Sample size
>>> p = 0.65            # Preference for Python
>>> q = 1.0 - p         # Preference for Ruby
>>> k = 500             # Room capacity

>>> # Approximation using the cumulative normal distribution
>>> from math import sqrt
>>> round(NormalDist(mu=n*p, sigma=sqrt(n*p*q)).cdf(k + 0.5), 4)
0.8402

>>> # Exact solution using the cumulative binomial distribution
>>> from math import comb, fsum
>>> round(fsum(comb(n, r) * p**r * q**(n-r) for r in range(k+1)), 4)
0.8402

>>> # Approximation using a simulation
>>> from random import seed, binomialvariate
>>> seed(8675309)
>>> mean(binomialvariate(n, p) <= k for i in range(10_000))
0.8406
طبقهبند بیزی ساده
توزیعهای نرمال معمولاً در مسائل یادگیری ماشین پدید میآیند.
ویکیپدیا مثال خوبی از یک دستهبند بیزی ساده دارد. چالش این است که جنسیت یک فرد از روی اندازهگیریهای ویژگیهایی با توزیع نرمال، شامل قد، وزن و اندازهی پا، پیشبینی شود.
یک مجموعهداده آموزشی شامل اندازهگیریهای ۸ نفر به ما داده شده است. فرض میشود که اندازهگیریها دارای توزیع نرمال باشند، بنابراین دادهها را با NormalDist خلاصه میکنیم:
>>> height_male = NormalDist.from_samples([6, 5.92, 5.58, 5.92])
>>> height_female = NormalDist.from_samples([5, 5.5, 5.42, 5.75])
>>> weight_male = NormalDist.from_samples([180, 190, 170, 165])
>>> weight_female = NormalDist.from_samples([100, 150, 130, 150])
>>> foot_size_male = NormalDist.from_samples([12, 11, 12, 10])
>>> foot_size_female = NormalDist.from_samples([6, 8, 7, 9])
سپس، با فرد جدیدی مواجه میشویم که اندازهگیریهای ویژگی او معلوم است، اما جنسیت او نامعلوم است:
>>> ht = 6.0        # height
>>> wt = 130        # weight
>>> fs = 8          # foot size
با شروع از احتمال پیشین ۵۰٪ برای مرد یا زن بودن، احتمال پسین را بهصورت احتمال پیشین ضربدر حاصلضرب درستنماییهای اندازهگیریهای ویژگی به شرط جنسیت محاسبه میکنیم:
>>> prior_male = 0.5
>>> prior_female = 0.5
>>> posterior_male = (prior_male * height_male.pdf(ht) *
...                   weight_male.pdf(wt) * foot_size_male.pdf(fs))

>>> posterior_female = (prior_female * height_female.pdf(ht) *
...                     weight_female.pdf(wt) * foot_size_female.pdf(fs))
پیشبینی نهایی به بیشترین احتمال پسین اختصاص مییابد. این بهعنوان بیشینه احتمال پسین یا MAP شناخته میشود:
>>> 'male' if posterior_male > posterior_female else 'female'
'female'